<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <author>
    <name>MaybeJustLikeThis</name>
  </author>
  <generator uri="https://hexo.io/">Hexo</generator>
  <id>https://maybejustlikethis.github.io/</id>
  <link href="https://maybejustlikethis.github.io/" rel="alternate"/>
  <link href="https://maybejustlikethis.github.io/atom.xml" rel="self"/>
  <rights>All rights reserved 2026, MaybeJustLikeThis</rights>
  <subtitle>写前端部署、全栈实践，和一点点 Agent 基建踩坑</subtitle>
  <title>MaybeJustLikeThis</title>
  <updated>2026-10-02T07:18:00.000Z</updated>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/categories/%E6%9D%82%E8%B0%88/"/>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/tags/%E6%9D%82%E8%B0%88/"/>
    <content>
      <![CDATA[<h1 id="网上又多了一门花学"><a href="#网上又多了一门花学" class="headerlink" title="网上又多了一门花学"></a>网上又多了一门花学</h1><p>常见老花给自己编了一门花学。开悟的人只做五件事，前四件是健身、赚钱、睡眠和饮食，第五件是学习花学。</p><p>最后这一项来得很突然，又好像没那么突然。前四项都是熟悉的生活建议，重视身体，努力生活，听着没什么可反对。学习花学跟着排在后面，乍听竟也像一件值得做的事。</p><p>《整个抖音就是体量最大的“精神批发市场”》讲的就是这样一场表演。老花一边给花学编主张，一边安排它怎样让人跟着学，连往后怎样传播都想好了。那些关于成长和清醒的话，换个名字就能重新开讲，台上也随时可以换个人。</p><p>我觉得这条视频的讽刺，正落在这种熟悉上。花学是临时编的。我们却很容易认出它的模样。</p><p>如果那张清单还不够有分量，老花又给它加上一场高端饭局。他设想自己刚从饭局回来，席间某位老板说了这些话。饭局还没讲完，讲述者已经有了见识，清单也有了来历，听众甚至不用知道老板究竟做什么，只要相信他所在的圈子足够高，就容易把后面的话听成某种难得的经验。</p><p>这么讲，听众先记住了那个见过世面的讲述者。他懂得那些我们接触不到的事，还愿意拿出来分享。普通建议经过这一番转述，就和一个值得跟随的人绑在了一起。</p><p>这也解释了为什么它总要谈开悟。单独劝人睡好一点，话讲完就结束了。把睡眠写进开悟清单，讲述者就能继续告诉你，一个清醒的人应该怎样生活。听众认可其中几项，很容易顺着清单接受那个更大的身份。关注花学，仿佛也算向那个理想中的自己靠近了一点。</p><p>老花借了《疯传》里的六个传播原则来搭这场戏。但一路看下来，最让人发笑的，是他能把同一套现成说法用得这么顺。花学几乎还没有内容，已经有了口气，也有了站在观众前面指点人生的姿态。</p><p>接着，他提到另一位博主鼓励大家每天发75条作品，再反过来替花学定了一条规矩，每天拉黑75个人。对方鼓励不断输出，他就宣扬成功在于屏蔽。连这个离谱的数字，都有一个现成的说法可以模仿。</p><p>少看让自己难受的内容，本来是一句很普通的建议。到了花学这里，它和保持聪明、改变生活也有了关系。刷到一条让自己焦虑、觉得自己不够好的视频，按下屏蔽就算做了一件有助于成长的事。75次又给这件事添了一个每天都能完成的指标。</p><p>这一来，刷手机也有了花学的做法。内容值不值得看，原本可以一条条判断，现在只要记住那个痛快的动作就行。一套关于怎样生活的主张，最后落在每天怎样操作手机上，照做起来倒很方便。</p><p>他还嫌拉黑不够热闹。自己按完按钮，别人看不见，这门学问就传不出去。于是他继续设想，让大家用共同的暗号，发拉黑记录，把说法做成语录卡和表情包，甚至编一条拉黑75个领导的帖子，等着别人截图讨论。</p><p>到这一步，花学已经有了自己的参与方式。观众能照着做，也能晒出来。有人认真认领，有人拿它开玩笑，这个名字都能继续出现。一个本来只发生在自己手机上的动作，经这么安排，就像有一群人正在共同实践某种生活态度。</p><p>这就接上了。和一开始那张开悟清单一样，分享这些话，也能顺带说明自己是怎样的人。谁还没弄明白生活究竟该怎么过，先照着一套已有的说法介绍自己，至少省事。说法有人替你写好了，连表示赞同的动作都有。</p><p>视频讲到买AI课时，又把这种省事往前推了一步。害怕自己跟不上变化，付钱买一门课，焦虑可能当时就轻了一些。到底学会了多少，还要以后再说，订单却已经确认了。</p><p>放在花学这场表演里，这一段的意味很清楚。一个人对生活的不安，可以被讲述者整理成一个容易购买的答案。花学先让人觉得有路可走，听众愿意继续听下去，再给他们一套容易照着做的办法，至于做完这些事情，生活能有多大改变，眼前还不必立刻回答。</p><p>在谈这些办法时，老花也提醒过，做内容得有真东西，空话只够做一次性生意。</p><p>快结束时，他又讲起自己参与一家老字号金店转型讨论的经历。金店想做年轻人的生意，于是聊到子品牌、代言人和选品。这些细节都很日常，听着像一段顺口提起的工作往事，刚好能说明他平时就接触这些问题。</p><p>讲到18分06秒，他承认自己编不下去了。</p><p>金店的故事也是编的。观众刚刚还在听他拆解这些套路，转眼也听完了一段替他本人增加可信度的经历。讲故事这件事，被他当场做了一次，又当场拆掉。</p><p>这个结尾让前面的花学更完整了。虚构的学问有了主张，有人愿意跟着说；传授学问的人需要一点资历，也可以现场补齐。足够让人点头的人生答案，就这样连人带话地准备好了。</p><p>最后，他说了句收摊。</p><p>连这个负责揭穿的人，也给自己安排了一个摊位。</p><p>原视频来自常见老花，<a href="https://www.douyin.com/video/7685400988232462516">《整个抖音就是体量最大的“精神批发市场”》</a>，18分46秒</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2026/10/02/%E7%BD%91%E4%B8%8A%E5%8F%88%E5%A4%9A%E4%BA%86%E4%B8%80%E9%97%A8%E8%8A%B1%E5%AD%A6/</id>
    <link href="https://maybejustlikethis.github.io/2026/10/02/%E7%BD%91%E4%B8%8A%E5%8F%88%E5%A4%9A%E4%BA%86%E4%B8%80%E9%97%A8%E8%8A%B1%E5%AD%A6/"/>
    <published>2026-10-02T07:18:00.000Z</published>
    <summary>常见老花临时编出一套花学，把互联网上那些熟悉的人生答案演了一遍。普通建议怎样变成个人学说，听众又怎样跟着它认识自己，这场讽刺从一张开悟清单开始。</summary>
    <title>网上又多了一门花学</title>
    <updated>2026-10-02T07:18:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="AI" scheme="https://maybejustlikethis.github.io/categories/AI/"/>
    <category term="AI" scheme="https://maybejustlikethis.github.io/tags/AI/"/>
    <content>
      <![CDATA[<blockquote><p>每一辆跑得快的车都该有刹车。这是句废话——直到你发现，整个 AI agent 赛道都在造更猛的引擎，没人装刹车。</p></blockquote><p>你大概有过这种时刻。给一个自主 agent 派了个活：「把这个登录 bug 修了。」它接走，后台跑了二十分钟，回头给你开了个 PR。你点开 diff，bug 确实修了。但它顺手还动了三个你压根没提的文件，其中一个在认证模块里。它觉得「refactor 一下更干净」。你后背有点凉。</p><p>这种凉不是因为这个 agent 笨。恰恰相反，是因为它太能干，能干到你根本没让它做的事它也顺手做了。而整个过程里，没有任何东西对它说「不」。</p><p>我觉得这才是这一轮 AI agent 浪潮里最被忽视的问题。所有人都在比谁更自主。Devin 强调你 assign 完就可以去喝咖啡，Copilot 的 coding agent 强调后台独立工作，Jules 恨不得告诉你它同时跑六十个任务，Multica 甚至能把 agent 像同事一样排进看板、让小队长分派任务、定时触发日报周报。方向高度一致：<strong>更少的人介入，更多的 agent 自走。</strong></p><p>这当然是好事。能自主干活的 agent，是这一波技术真正值钱的地方。</p><p>但我慢慢发现一个不太对劲的对称性缺失：<strong>我们给 agent 踩到底的油门，却忘了给它装刹车。</strong></p><p>「刹车」在这里是个具体的、一点都不浪漫的东西——在 agent 真正去改一个文件之前，有没有一道机制能判定：这个文件，它今天能不能碰？如果它在修 bug 的路上顺手摸了认证模块，有没有东西当场拦下它，而不是等它全改完了再靠人 review diff 兜底？</p><p>答案几乎是：没有。你去翻这些产品的边界，它们基本都停在 issue 级、PR 级，或者仓库分支级。「把任务派给谁」「什么时候派」「派给哪台机器跑」——这些<strong>调度</strong>问题，它们解决得很好。但「agent 落笔改文件的那一瞬间，这个写动作到底允不允许」——这个问题，它们不答。</p><p>这事在系统工程里其实有个老说法。安全关键系统有一条基本原则叫 fail-closed：出了异常、判不准的时候，默认停机，宁可不动也不能乱动。电梯失电抱闸，核电站失控紧急停堆，自动驾驶感知冲突时踩刹车——都是 fail-closed。它的潜台词是：<strong>有些场合，「什么都不做」比「做点什么」安全得多。</strong></p><p>而几乎所有 AI agent，默认是 fail-open 的。它们被训练成「尽量帮用户把事办成」，遇到边界模糊、权限不清的情况，倾向于往前迈一步试试，而不是停下来问。一个 fail-open 的系统，平时特别好使，因为它总在帮你。直到有一天它帮你帮过了头。</p><p>我得承认，让 agent 自主，本身没什么毛病。一个能自己规划、自己执行、自己提 PR 的 agent，是过去几年最让人兴奋的东西。我自己也用得很爽。</p><p>可「能用」和「能放心用」之间，差着一道门槛。门槛就是：<strong>当它做错了，是在它动手之前就被挡住，还是在它做完之后才被发现。</strong> 前者叫约束，后者叫 review。这俩看着都拦住了问题，代价却天差地别——前者是 agent 压根改不了它不该改的，后者是你得在每一个 PR 里瞪大眼睛找它偷摸改了什么。团队一大、PR 一多，后者根本兜不住。</p><p>再往深想一层，这其实不只是技术问题，是责任问题。</p><p>当一个能改生产代码的 agent 真的进了团队，「它被允许改哪些文件」就不只是个配置项，是一道责任线。出事了——线上挂了、密钥泄了、认证逻辑被悄悄改坏了——谁担？如果 agent 既是写代码的那个、又是审查的那个，那等于没人审。企业治理里有一条快被说烂但永远成立的底线：<strong>生成和审查必须分离，人类对最终落下来的那一行代码负责。</strong></p><p>这条底线，在 agent 越自主的时候，越容易被悄悄绕过。因为自主的 agent 太顺手了，顺手到你会忘了它也是会犯错的、也是会被诱导的、也是需要被喊停的。</p><p>所以我现在越来越觉得，这一波缺的不是更强的 agent，是给所有 agent 的那一脚制动。</p><p>它不需要很重。一道在每次写文件前判一下路径的 hook，一次必须由人按下才推进的阶段切换，一条「想改代码先退回去显式说明」的递进锁，就够了。它甚至不该是个独立的大产品，它最好是那种能装进任何 agent 工具链的、极轻的一层——<strong>让 agent 该自主的时候自主，但在它越界的那一刻，有个东西能默认说不。</strong></p><p>回到开头那句废话。引擎造得再猛的车，没刹车是上不了路的。只不过这一次，「车」是会自己改你生产代码的 agent，而我们还停在比谁引擎更猛的阶段。</p><p><em>（<a href="https://github.com/MaybeJustLikeThis/task-loop">task-loop</a> 是这个思路的一个极轻开源实现：给 Claude Code 装一个 fail-closed 的文件级守门 hook，越界写当场拦，阶段切换人发车。）</em></p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2026/06/18/%E4%B8%BA%E4%BB%80%E4%B9%88%E8%87%AA%E4%B8%BBagent%E9%9C%80%E8%A6%81%E4%B8%80%E9%81%93%E5%88%B9%E8%BD%A6/</id>
    <link href="https://maybejustlikethis.github.io/2026/06/18/%E4%B8%BA%E4%BB%80%E4%B9%88%E8%87%AA%E4%B8%BBagent%E9%9C%80%E8%A6%81%E4%B8%80%E9%81%93%E5%88%B9%E8%BD%A6/"/>
    <published>2026-06-18T07:00:00.000Z</published>
    <summary>全行业都在让 AI 更自主，但没人给它装刹车。为什么 fail-closed 的执行约束，是 agent 进生产的前提。</summary>
    <title>为什么自主 agent 需要一道刹车</title>
    <updated>2026-10-19T15:31:12.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="AI" scheme="https://maybejustlikethis.github.io/categories/AI/"/>
    <category term="AI" scheme="https://maybejustlikethis.github.io/tags/AI/"/>
    <content>
      <![CDATA[<blockquote><p>能做和能上线之间，隔着一条叫”可靠性”的鸿沟。</p></blockquote><p>ChatGPT 刚出来那会儿，很多人都有过一种错觉：这东西太强了，给它接上 API、挂上工具，是不是就能代替人干活了？我自己也这么想过。你让它帮你查个天气、订个外卖，它确实能聊得头头是道，感觉离”数字员工”就差一步。</p><p>但真动手做过 Agent 项目的人都知道，从”能聊天”到”能干活”这一步，远比想象中难。差距不在提示词写得好不好——Chatbot 只需要把话说对，Agent 还要把事做对。前者出错了你最多翻个白眼，后者出错了你可能是数据库没了。</p><p>所以一个能干活的 Agent，最小可行结构是什么样的？从 Demo 里跑通一个 Agent 到真正把它推上生产，中间到底缺了什么？这篇文章想聊聊这件事。</p><p>先从最基本的结构讲起。不管外面包装得多花哨，一个 Agent 的核心循环其实就这么简单：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">while</span> <span class="keyword">not</span> done:</span><br><span class="line">    thought = llm.think(context)      <span class="comment"># 想</span></span><br><span class="line">    action = llm.decide(thought)      <span class="comment"># 决定做什么</span></span><br><span class="line">    observation = tools.execute(action)  <span class="comment"># 做</span></span><br><span class="line">    context.update(observation)       <span class="comment"># 把结果记下来</span></span><br></pre></td></tr></table></figure><p>就这几行。想、做、看、记，循环往复，直到任务完成。几乎所有 Agent 框架——不管是 LangChain 的 AgentExecutor 还是 AutoGPT 的主循环——本质上都是这个结构的变体。</p><p>这个循环里有三个组件：LLM 是大脑，负责理解意图、规划步骤、做出决策；Tools 是手脚，搜索引擎、数据库、API、文件系统，都是 Agent 和外部世界交互的通道；Memory 是记忆，让 Agent 知道自己之前干了什么、走到哪一步了。没有记忆的 Agent 就像一个失忆症患者，每一步都在重复上一轮的思考。</p><p>Memory 这块值得展开说，因为它在实践中的选择比大多数人想的要复杂。光”记住之前做了什么”这一件事，就有好几种方案，各有各的适用场景和坑：</p><table><thead><tr><th>方案</th><th>原理</th><th>适合场景</th><th>局限性</th></tr></thead><tbody><tr><td>对话缓冲（Buffer）</td><td>把所有历史对话原样塞进 context</td><td>轮次少、token 预算充裕的短任务</td><td>轮次一多就爆 context，完全没有压缩</td></tr><tr><td>滑动窗口（Window）</td><td>只保留最近 N 轮，更早的丢弃</td><td>对话型 Agent、轮次多但旧上下文不关键</td><td>丢掉的可能是关键信息，”第 3 轮说过的话”彻底消失</td></tr><tr><td>摘要压缩（Summary）</td><td>用 LLM 把历史对话压缩成摘要</td><td>长链任务、上下文重要但不需要原文</td><td>压缩过程本身消耗 token，且可能丢失细节</td></tr><tr><td>向量存储（Long-term）</td><td>把历史交互写入向量数据库，按需检索</td><td>跨会话记忆、知识量大的场景</td><td>检索质量依赖 embedding 模型，增加了一层复杂度</td></tr><tr><td>结构化状态（State）</td><td>用 key-value 或 JSON 保存明确的任务状态</td><td>流程化任务、需要精确追踪进度</td><td>只能存预定义的字段，灵活性差</td></tr></tbody></table><p>没有哪个方案是万能的。短任务用对话缓冲就够了，长链任务需要摘要压缩，跨会话场景才值得上向量存储。实际生产中往往是组合使用——滑动窗口保近期细节，摘要压缩保中期记忆，向量存储保长期知识。选型的关键是想清楚：你的 Agent 到底需要”记住什么”，以及能为记忆付出多少 token 预算。</p><p>把这三个东西拼到一起，就得到了 ReAct 模式。ReAct 是 Reasoning + Acting 的缩写，最早在 2022 年的一篇论文里被系统地提出来。它的核心直觉很朴素：Agent 不应该”想完再动”或者”不动只想”，而应该边想边动、边动边想。每一步思考之后立即执行一个动作，观察动作的结果，再基于这个结果决定下一步。Thought → Action → Observation，循环推进。</p><p>这个模式之所以成为事实上的标准，就是因为它足够自然。人解决复杂问题的时候就是这么干的——你不会在脑子里把所有步骤都推演完毕再动手，你先做一步看看结果，然后调整。ReAct 把这个直觉形式化了。</p><p>但 ReAct 是一个好的起点，却不是一个好的终点。它只解决了 Agent “能不能跑”的问题，没解决”能不能靠谱地跑”的问题。</p><p>这就引出了一个更现实的问题：为什么裸 Agent 上不了生产？</p><p>说”上不了”可能有点绝对。更准确地说，一个没有工程包装的裸 Agent，在生产环境中几乎必然失败。失败的方式还挺多样的：</p><ul><li><p>工具调用不可控。Agent 觉得需要某个工具就调了，但你没给它设边界。让它管理服务器，它可能心血来潮把负载均衡器给删了——因为从它的推理链来看，”减少不必要的组件”是合理的。听起来荒谬，但 LLM 的推理链里这种”逻辑自洽但结果灾难”的情况一点都不罕见。</p></li><li><p>上下文爆炸。Agent 循环每走一步，上下文就膨胀一圈——历史对话、工具返回结果、中间推理过程，全部塞进去。跑个十几轮之后，token 飙升到模型上下文窗口的天花板，Agent 开始丢失关键信息或者做出荒腔走板的判断。更糟的是，有些框架根本没有上下文管理机制，就让它一直膨胀到崩掉。</p></li><li><p>错误不可恢复。Agent 调用了一个工具，工具报错了。然后呢？裸 Agent 的典型行为是把错误信息塞回上下文，让 LLM 再想想。但 LLM 面对错误信息时往往会陷入重复尝试的死循环——用同样的方式再调一次，再失败，再重试。没有退避策略，没有降级方案，一个 tool 调用的失败就能把整个任务卡死。</p></li><li><p>行为不可观测。Agent 跑挂了，你打开日志一看，密密麻麻的文本输出，没有结构化的 trace 链路，没有步骤编号，没有 cost 统计。你甚至不知道它到底是在第三步还是第八步出的错，也不知道那一步到底调了什么工具、传了什么参数。出了问题不知道哪步出错，排查起来就是大海捞针。</p></li><li><p>幻觉导致执行危险操作。这是最让人后怕的。LLM 会”编”出一些不存在的东西，这在聊天场景里顶多是个笑话，但在 Agent 场景里可能是个灾难。举个最直白的例子：Agent 负责管理数据库，用户让它”清理测试数据”，Agent 幻觉出了一个合理的 SQL，执行了 <code>DROP TABLE users</code>——不是 <code>test_users</code>，是 <code>users</code>。表没了。生产数据没了。而且它还觉得自己做对了。</p></li></ul><p>说白了，就是不可靠。</p><p>这些失败模式不是理论推演，每一个都是实际踩过的坑。裸 Agent 就像一个没有刹车、没有仪表盘、没有安全带的车——发动机能转，但你不会开上高速。</p><p>所以问题的本质其实变了：不是”Agent 能不能做”，而是”怎么让 Agent 在可控的范围内做”。这就需要一层东西包在外面。</p><p>Harness 这个词在工程领域用得很广泛，通常翻译成”线束”或者”测试套件”，但在 Agent 的语境下，我更愿意把它理解成包裹在 Agent 外层的工程基础设施——负责控制、监控、恢复。如果 Agent 本身是发动机，Harness 就是围绕发动机搭建的整车系统：油路控制、仪表盘、安全气囊、ABS 防抱死。</p><p>拿工具权限来说。裸 Agent 的问题是所有工具对所有场景一视同仁，但这在生产环境里是不可接受的。Harness 要做的第一件事就是按角色、按场景给工具加权限——Agent 在执行查询任务的时候，不应该有写入和删除的权限；在测试环境里可以随意操作，切到生产环境，所有危险操作必须走审批。最小权限原则，和给服务器做权限管理是同一个逻辑。</p><p>上下文管理是另一个容易踩的坑。裸 Agent 的上下文只增不减，但 Harness 需要一套策略来控制膨胀：滑动窗口，只保留最近 N 轮的完整交互，更早的只保留摘要；让 LLM 自己把长对话压缩成关键信息；把任务目标、用户约束、安全规则这些不能丢的东西钉在 context 头部，确保不管怎么裁剪，核心指令始终在线。这块容易被忽视，但在长链任务里其实是生存必需——上下文一崩，Agent 就等于失忆了。</p><p>再往下就是错误恢复。裸 Agent 遇到错误就卡住，Harness Agent 遇到错误会有一套策略。具体怎么选，取决于错误的类型和你的容错偏好：</p><table><thead><tr><th>策略</th><th>做法</th><th>适用场景</th><th>代价</th></tr></thead><tbody><tr><td>立即重试（Retry）</td><td>同样的调用再来一次</td><td>临时性故障，比如网络抖动、API 限流</td><td>如果是持久性故障，纯属浪费时间</td></tr><tr><td>指数退避（Backoff）</td><td>第 1 次等 1s，第 2 次等 2s，第 3 次等 4s</td><td>API 限流、下游过载</td><td>总延迟变长，需要设上限防止无限等待</td></tr><tr><td>降级（Fallback）</td><td>换一个备用工具或 API</td><td>主路径不可用但有替代方案</td><td>替代方案的结果质量可能不如主方案</td></tr><tr><td>跳过（Skip）</td><td>跳过当前步骤，用默认值继续</td><td>非关键步骤失败，不值得阻塞整体</td><td>结果不完整，需要在报告里标注</td></tr><tr><td>断路器（Circuit Break）</td><td>多次失败后直接中断，通知上层</td><td>持续性故障、下游彻底不可用</td><td>任务直接中止，需要人工介入</td></tr></tbody></table><p>这些模式在传统的微服务工程里已经非常成熟了，只不过现在需要搬到 Agent 的场景里重新实现一遍。一个常见的组合是：遇到错误先退避重试三次，仍然失败就降级，降级也失败就断路——层层递进，比”出错了让 LLM 再想想”靠谱得多。</p><p>可观测性做的事听起来不性感，但在生产环境里极其重要。结构化日志，每一步的输入输出都有标准化的格式；trace 链路，类似 OpenTelemetry 那种，你能看到 Agent 从第一步到最后一步，每一步调了什么工具、传了什么参数、花了多少 token、返回了什么结果。cost tracking 也很关键——Agent 跑一次任务烧了多少 token、花了多少钱，得有数。不然月底一算账，发现 Agent 的 API 调用费比预期多了两个数量级，那就不是技术问题了，是业务问题。</p><p>还有一件事不得不提：不是所有决策都应该交给 Agent 自主完成。删除操作、大额支出、不可逆的配置变更——这些关键节点，Harness 应该暂停执行，等人类确认之后才继续。这看起来像是”退步”，毕竟 Agent 的卖点就是自主性。但在生产环境里，完全自主和完全不可控之间只有一线之隔。在关键决策前加一个确认步骤，不是对 Agent 能力的不信任，是对业务安全的最低尊重。</p><p>用同一个任务串起来看会更直观。假设任务是：部署一个新版本的服务到生产环境。</p><p>裸 Agent 的版本大概是这样的：Agent 接到任务，开始规划步骤——拉取最新代码、运行测试、构建镜像、部署上线。看起来没问题。但跑到部署那一步的时候，Agent 决定先把旧版本的容器全部停掉再启动新版本——<strong>这确实是一种部署策略，只不过是一种会导致服务中断的策略</strong>。它还顺手把旧的 Docker 镜像清理了。新版本启动之后发现有个配置没对，服务起不来。Agent 想回滚，但旧镜像已经被删了。你去看日志，发现只有一堆 LLM 的文本输出，没有结构化的执行记录，排查了半天才知道是第三步的环境变量写错了。 meanwhile，生产环境已经断了二十分钟。</p><p>Harness Agent 的版本完全不同。同样是部署任务，但在执行之前，Harness 先检查权限——这个 Agent 只有测试环境的写入权限，生产环境的部署操作需要触发确认机制。人类审批通过后，Agent 开始执行，每一步的操作都被记录在结构化的 trace 链路里。部署策略被限制在预设的白名单里——只允许蓝绿部署或滚动更新，不允许一次性停掉所有旧容器。镜像清理被标记为危险操作，必须经过二次确认。如果在任何一步出错——比如新版本启动失败——断路器立即触发，自动回滚到旧版本，同时把错误详情和完整 trace 发给值班人员。</p><p>整个过程里，Agent 的推理能力没变，LLM 还是那个 LLM。但外层的 Harness 确保了：权限有边界、操作有记录、错误有兜底、关键节点有人把关。</p><table><thead><tr><th>维度</th><th>裸 Agent</th><th>Harness Agent</th></tr></thead><tbody><tr><td>工具权限</td><td>所有工具随时可用</td><td>按场景、角色授权</td></tr><tr><td>上下文管理</td><td>无限膨胀直到崩溃</td><td>滑动窗口 + 摘要压缩</td></tr><tr><td>错误处理</td><td>重复尝试或直接卡死</td><td>重试 + 降级 + 断路器</td></tr><tr><td>可观测性</td><td>文本日志，难以排查</td><td>结构化 trace + cost tracking</td></tr><tr><td>安全控制</td><td>无</td><td>关键操作需人类确认</td></tr></tbody></table><p>一句话：Agent &#x3D; LLM + Tools + Memory，生产级 Agent &#x3D; Agent + Harness。ReAct 给了 Agent 一个能跑的骨架，Harness 给了它上生产的资格。</p><p>骨架搭好了，但光有骨架还不够。一个只会用工具的 Agent，和一个真正理解业务、能基于领域知识做判断的 Agent，中间还差一样东西——知识。下篇聊聊 RAG，聊聊怎么给 Agent 的骨架里注入灵魂。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2026/06/06/Agent%E5%B7%A5%E7%A8%8B%E5%8C%96%EF%BC%88%E4%B8%80%EF%BC%89%E4%BB%8EReact%E5%88%B0Harness/</id>
    <link href="https://maybejustlikethis.github.io/2026/06/06/Agent%E5%B7%A5%E7%A8%8B%E5%8C%96%EF%BC%88%E4%B8%80%EF%BC%89%E4%BB%8EReact%E5%88%B0Harness/"/>
    <published>2026-06-05T16:00:00.000Z</published>
    <summary>从 ReAct 模式出发，解释为什么裸 Agent 上不了生产环境，以及 Harness 工程要解决的核心问题</summary>
    <title>Agent 工程化（一）：从 ReAct 到 Harness——Agent 的骨架是怎么搭出来的</title>
    <updated>2026-10-19T15:31:12.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="AI" scheme="https://maybejustlikethis.github.io/categories/AI/"/>
    <category term="AI" scheme="https://maybejustlikethis.github.io/tags/AI/"/>
    <content>
      <![CDATA[<blockquote><p>编排不是让 Agent 变得更聪明，是让它们各自做对的事。</p></blockquote><p>你的 Agent 已经会查数据库了，会写代码了，会发通知了。单看每一项都还不错。但当你让它同时做这三件事——先从数据库查出问题，写一段修复代码，再发邮件通知相关人员——事情就开始失控了。上下文窗口塞满了数据库 schema、代码规范、邮件模板，Agent 开始用写代码的逻辑去组织邮件内容，或者在应该发通知的时候跑回去重新查一遍数据库。你不禁怀疑：这东西单独用的时候明明挺靠谱的？</p><p>单 Agent 的瓶颈不是能力不够，是<strong>上下文和角色冲突</strong>。一个人再强，也没法同时当产品经理、工程师和测试——你脑子里同时装三套完全不同的指令体系、工具描述和历史记录，最后的结果一定是互相干扰。Agent 也一样。</p><p>那什么时候该拆成多 Agent？怎么编排？拆完之后怎么保证不翻车？</p><p>这三篇系列走到这里，第一篇搭了骨架，第二篇注入了知识，这一篇想聊的是——当骨架和知识都不够用的时候，怎么通过编排让多个 Agent 分工协作。</p><p>先说清楚一件事：为什么要拆。</p><p>答案不是”多个 Agent 更厉害”。说实话，如果你的任务足够聚焦、上下文足够干净，单个 Agent 完全够用，拆了反而增加复杂度。需要拆是因为三个实实在在的天花板。</p><p>上下文污染是第一个。不同任务的指令、工具描述和历史记录混在同一个 context 里，会互相干扰。这不是理论上的担忧，是实际会发生的——你在 system prompt 里同时塞了”写代码要遵循 PEP8”和”邮件要简洁得体”，Agent 就可能在代码注释里用邮件的口吻写东西，或者在邮件正文里冒出变量名。原因很简单：注意力机制在所有的 token 之间做加权平均，任务边界模糊的时候，不同领域的模式会串。</p><p>然后是角色漂移。Agent 在执行过程中会逐渐偏离原本的职责。一个挺典型的例子：让 Agent 写代码，它写着写着开始觉得项目结构”不够优雅”，自作主张地去重构目录、删掉它认为”不必要”的文件。你说它错了吗？它的推理链看起来挺有道理的。但问题在于——你只让它写一个函数，它给自己加了活。单 Agent 没有角色边界，所有任务共享同一个”人格”，一旦中间某个环节触发了 Agent 的”优化欲”，后面的任务就跟着跑偏了。</p><p>还有一个容易被忽略的问题——单点故障。一个环节出错，整条链路崩溃，没有隔离。比如你的 Agent 在调用一个外部 API 时超时了，陷入重试死循环，而同一个 Agent 负责的其他任务也跟着卡住——因为它在同一轮对话里，重试占用了推理路径，后面的任务排不上队。没有隔离带，一个着火的房间会把整栋楼烧掉。</p><p>说白了，多 Agent 的本质是三件事：分工、隔离、并行。不是为了”更厉害”，是为了让每个 Agent 的上下文干净、角色明确、故障不扩散。一个人干三件事会顾此失彼，三个人各干一件事就不会。这不是个人能力的问题，是认知负载和协作效率的问题。</p><hr><p>那怎么拆？拆完之后怎么把它们组织起来？</p><p>我用同一个场景来对比：自动化代码审查系统。一个 PR 提交上来，你需要多个 Agent 协作完成审查。这个场景足够复杂，能暴露出不同编排模式的差异。</p><p>最直觉的做法是 <strong>Pipeline</strong>——Agent A 做完交给 Agent B，Agent B 做完交给 Agent C，严格串行。代码审查里就是：代码提交 → 静态分析 Agent 扫一遍 → 安全审查 Agent 再查一遍 → 最后报告 Agent 生成总结。每个 Agent 的输入是上一个的输出，职责清晰，谁先谁后一目了然。可预测、好调试，出了问题顺着链路找就行。但慢也是真的慢——静态分析跑了五分钟，安全审查就在那干等。一个环节卡住，全线等待。对于有严格依赖关系的任务（B 的输入确实需要 A 的结果），Pipeline 是合理的。但如果任务之间没有先后依赖，你就是在浪费时间。</p><p>如果你发现多个审查任务其实可以同时进行，那就该考虑 <strong>Fan-out &#x2F; Fan-in</strong> 了。一个调度器把代码同时分发给三个 Agent：Bug 检测看逻辑错误，性能分析看热点，安全审查查注入和权限。各自独立跑，最后汇总成一份报告。并行带来的速度提升是实打实的。但汇总那个环节会变成头疼的事——三个 Agent 的输出格式可能不一样，严重程度的定义可能不统一，甚至结论可能互相矛盾。你得在汇聚阶段做大量的格式对齐和冲突消解工作。</p><p>再往上走一层，如果你不仅需要并行，还需要一个”大脑”来统筹全局，就用 Hierarchical 编排。一个主 Agent 负责拆解任务、分配给子 Agent、汇总决策。在代码审查场景里，主 Agent 接到”审查这个 PR”的指令后，先分析变更的范围和涉及的模块，然后把不同文件分给最合适的子 Agent——后端代码给 Bug Detector，API 变更给 Security Reviewer，样式变更给 Style Checker。子 Agent 各自做完，主 Agent 再汇总、去重、按严重程度排序。主 Agent 保持了全局视野，能做更智能的任务分配和结果整合。代价是它本身成了瓶颈——上下文窗口要装下所有子 Agent 的摘要，它挂了整个系统就停了。</p><p>还有一种比较特殊的模式——<strong>黑板模式（Blackboard）</strong>。没有严格的调度关系，多个 Agent 独立读写一个共享的状态空间（就是”黑板”），通过黑板间接协作。代码审查场景下，多个 Agent 同时分析一份代码变更，各自把发现写在黑板上，互相能看到对方的结论，甚至可以补充和修正。加一个新 Agent 不需要改任何调度逻辑，直接往黑板上写就行。听起来很灵活，但灵活性的另一面是协调成本——谁先写？写冲突了怎么办？两个 Agent 对同一段代码给出相反的评价怎么处理？这些都需要额外的机制来管理。</p><p>怎么选？<strong>从 Pipeline 开始。</strong> 它最简单，够用就不要加复杂度。当你发现等待时间成了瓶颈，升级到 Fan-out。当你需要更智能的任务分配和全局决策，用 Hierarchical。至于 Blackboard，留给你真的需要高度灵活、松耦合协作的场景——说实话，大多数生产系统暂时还用不到。</p><hr><p>编排不只是画个流程图。</p><p>很多人一开始接触多 Agent 编排，会把它想象成画一个 DAG（有向无环图），定义好节点和边，任务就自己跑起来了。在 Demo 里确实是这样。但到了生产环境，你会发现 DAG 只解决了”谁先谁后”的问题，真正的工程挑战在别处。</p><p>最头疼的是状态管理。Agent A 产出了 5000 token 的分析结果，Agent B 不需要全部信息，你怎么做截断或者摘要？这些问题看似琐碎，在生产里经常变成最大的坑。常见的做法是定义一个标准化的消息格式（比如 JSON schema），用中间存储（Redis、文件系统、数据库）做传递，而不是直接在 prompt 里塞全部内容。</p><p>状态管理如果没做好，错误来了就更难办。子 Agent 挂了怎么办？重试几次？还是失败的话是降级还是跳过？需不需要通知人类介入？不同环节的策略可能完全不一样——安全审查失败了不能跳过，但风格检查失败了可以先跳过，后续补上就行。你需要在编排层为每个 Agent 定义失败策略。</p><p>还有几个容易被忽略但真会出事的细节。超时控制——Agent 不是每次都能在合理时间内完成。有时候是 LLM API 响应慢，有时候是 Agent 陷入了循环推理。你需要为每个环节设置超时阈值，超时之后有明确的 fallback 逻辑。不然一个 Agent 卡住了，下游全卡住，排查的时候你会发现日志里什么有用的信息都没有。并发控制——同时跑太多 Agent，API rate limit 打满，成本飙升；跑太少，并行的优势出不来。这本质上是个资源调度问题。</p><p>然后是可观测性和成本控制，这两个其实是一体两面。多 Agent 系统出了问题怎么排查？你需要 trace——每个 Agent 的输入是什么、输出了什么、花了多长时间、消耗了多少 token。像分布式链路追踪一样，给每个任务一个 trace ID，串联起所有 Agent 的执行记录。每个 Agent 的 token 消耗都要追踪，尤其是层级式编排里，主 Agent 的上下文会随着子 Agent 的增加而膨胀，成本不是线性增长而是指数增长。不然一个月跑下来账单能吓你一跳。</p><p>这些是编排的”运维层”。就像 K8s 不只是调度容器，还管健康检查、自动扩缩容、滚动更新、资源限额。编排也是一样——DAG 只是表面，底下是一整套系统工程。</p><hr><p>说完了模式，用一个完整的案例把前面的东西串起来。</p><p>假设我们要构建一个多 Agent 代码审查系统。采用 Hierarchical 编排，结构如下：</p><ul><li>Orchestrator Agent：接收代码变更，分析变更范围，拆分审查任务</li><li>Bug Detector Agent：专注逻辑错误和边界条件</li><li>Security Reviewer Agent：专注注入、权限、敏感数据</li><li>Style Checker Agent：专注代码风格和一致性</li><li>Report Agent：汇总所有审查结果，去重，按严重程度排序，生成报告</li></ul><p>有几个设计决策值得聊一下。</p><p>为什么选 Hierarchical 而不是 Fan-out？Fan-out 更简单，直接把代码同时扔给三个 Reviewer 就行。但问题在于——代码审查不是无脑并行。一个 PR 改了 50 个文件，其中 30 个是样式变更，15 个是后端逻辑，5 个涉及 API 权限。Fan-out 模式下三个 Agent 都要读全部文件，浪费且容易产生重复发现。Hierarchical 模式下 Orchestrator 先做一轮分析，把文件按类型分给最合适的 Reviewer，既省 token 又减少重复。</p><p>错误处理策略上，如果某个 Reviewer Agent 超时了，我选了降级方案——跳过那个 Reviewer 的结果，用已有的部分报告继续推进，同时在报告里标注”安全审查未完成，建议人工复核”。这比整体阻塞要好得多。宁可给一份不完整的报告，也不要让用户等到超时然后什么都没拿到。</p><p>成本控制方面，大文件不全量分析，只审查 diff 部分。一个 5000 行的文件，这次只改了 30 行，那只有这 30 行及其上下文会进入 Reviewer 的 context。看起来是个小优化，但在大型项目里能省掉 80% 以上的 token 消耗。</p><p>简化的编排流程大致是这样的：</p><figure class="highlight text"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br></pre></td><td class="code"><pre><span class="line">输入：代码变更（PR diff）</span><br><span class="line">  │</span><br><span class="line">  ▼</span><br><span class="line">Orchestrator Agent</span><br><span class="line">  ├── 分析变更范围（文件类型、模块归属、变更量）</span><br><span class="line">  ├── 拆分审查任务</span><br><span class="line">  │     ├── 后端逻辑 → Bug Detector</span><br><span class="line">  │     ├── API/权限 → Security Reviewer</span><br><span class="line">  │     └── 样式/格式 → Style Checker</span><br><span class="line">  ├── 等待结果（带超时）</span><br><span class="line">  │     └── 超时 → 降级，标记未完成项</span><br><span class="line">  └── 汇总结果 → Report Agent</span><br><span class="line">                  ├── 去重（多个 Reviewer 可能发现同一问题）</span><br><span class="line">                  ├── 排序（按严重程度：Critical &gt; Warning &gt; Info）</span><br><span class="line">                  └── 输出审查报告</span><br></pre></td></tr></table></figure><p>每个箭头背后都有一组工程细节——状态传递的格式、超时阈值、重试策略、token 预算。这些细节才是系统真正能跑起来的关键。</p><hr><p>三篇写完了，回头看看这个系列。</p><p>第一篇搭了 Agent 的骨架——LLM + Tools + Memory，加上 Harness 让它可靠地跑起来。第二篇聊了知识——RAG 让 Agent 能”懂”你的私有数据，核心是检索质量和注入策略。这一篇讲的是协作——当单个 Agent 的上下文和角色边界撑不住的时候，通过编排让多个 Agent 分工协作，核心不是 DAG 画得漂亮，而是状态管理、错误处理、可观测性这些工程细节。</p><p>拼在一起就是：<strong>骨架让它能动，知识让它能懂，编排让它能协作。</strong> 三者缺一，Agent 就还停留在 Demo 阶段。</p><p>最后说一点务实的感受。多 Agent 编排听起来很酷，也是现在 Agent 框架宣传的重点。但我觉得对于大多数场景，先让单 Agent 跑稳比急着拆成多 Agent 重要得多。很多问题看起来是多 Agent 的需求，实际上只是单 Agent 的 system prompt 没写好、上下文没管理干净。等你真的碰到了上下文污染、角色漂移这些天花板，再拆也不迟。拆是手段，不是目的。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2026/06/06/Agent%E5%B7%A5%E7%A8%8B%E5%8C%96%EF%BC%88%E4%B8%89%EF%BC%89%E7%BC%96%E6%8E%92%E7%9A%84%E6%9C%AC%E8%B4%A8/</id>
    <link href="https://maybejustlikethis.github.io/2026/06/06/Agent%E5%B7%A5%E7%A8%8B%E5%8C%96%EF%BC%88%E4%B8%89%EF%BC%89%E7%BC%96%E6%8E%92%E7%9A%84%E6%9C%AC%E8%B4%A8/"/>
    <published>2026-06-05T16:00:00.000Z</published>
    <summary>解释单 Agent 的能力天花板，四种主流编排模式的实际选择，以及生产中多 Agent 系统的工程挑战</summary>
    <title>Agent 工程化（三）：编排的本质——从单 Agent 到多 Agent 协作</title>
    <updated>2026-10-19T15:31:12.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="AI" scheme="https://maybejustlikethis.github.io/categories/AI/"/>
    <category term="AI" scheme="https://maybejustlikethis.github.io/tags/AI/"/>
    <content>
      <![CDATA[<blockquote><p>检索是找到文档，RAG 是让模型基于文档生成正确的回答——这两者之间的距离，就是一整套工程系统。</p></blockquote><p>你让一个 Agent 去查公司的退款政策，它可能会给你两个结果：要么编一个听起来很合理的规则——“7 天无理由退款，需保持商品完好”——但它其实是从训练数据里某个电商 FAQ 学来的，跟你公司一点关系都没有；要么它确实找到了你们公司的退款政策，但那是 2023 年 3 月的旧版本，早在去年 9 月就已经改过了。</p><p>这就是 LLM 最根本的两个知识缺陷：知识有截止日期，而且它不知道你公司内部发生了什么。训练数据再丰富，也覆盖不了你企业知识库里的那几十万份文档、不是昨天的产品变更、不是只有内部员工才看得懂的术语表。</p><p>上一篇我们聊了 Agent 的骨架——LLM + Tools + Memory + Harness。骨架搭好了，但光有骨架的 Agent 就像一个什么都不知道的新员工：它能用工具、能执行流程，但问它任何业务相关的问题，它要么说”我不知道”，要么更危险——假装知道。</p><p>所以怎么让 Agent 真正”懂”你的数据？答案指向一个被说烂了但很少被说清楚的词：RAG。问题在于，大多数人理解的 RAG 就是”接个向量数据库”，这距离真正能用的 RAG pipeline 差了十万八千里。</p><p>先回到最基本的。RAG 这四个字母是 Retrieval-Augmented Generation 的缩写，直译就是”检索增强生成”。直觉上其实很朴素：用户问了一个问题，你先从知识库里把相关的内容找出来，然后把这些内容连同问题一起交给 LLM，让它基于这些内容生成回答。四个步骤——Query、Retrieve、Augment、Generate——说白了就是：提问、检索、拼上下文、生成回答。</p><p>但这和”搜索”有什么区别？</p><p>区别大了。搜索是”找到相关文档，你自己看”。RAG 是”找到相关文档，让 LLM 读完之后替你总结、推理、回答”。搜索结果是一堆链接，RAG 的产出是一段经过理解之后的回答。这个区别听起来微妙，但在工程上意味着完全不同的要求和复杂度——搜索只需要召回率，RAG 还需要检索结果的质量足够好，好到 LLM 能基于它生成准确的回答，而不是被噪声带偏。</p><p>可惜现实中，人们对 RAG 的误解比理解多。最常见的一个：把 RAG 等同于向量搜索。这当然可以理解——大部分 RAG 教程的第一步都是”把文档切成 chunk 然后塞进向量数据库”，很容易让人觉得向量搜索就是 RAG 的全部。但向量搜索只是检索环节的一种手段，检索本身又只是 RAG 四步中的一步。Query 怎么理解、检索结果怎么排序和过滤、喂给 LLM 之前怎么组装上下文、生成之后怎么验证回答质量——每一个环节都能决定最终效果。把向量搜索等同于 RAG，就好比把”去超市买食材”等同于”做了一桌菜”。</p><p>还有一些更微妙的认知偏差。比如觉得 chunk 切得越细检索精度就越高——这听起来有道理，但粒度太细会切断语义完整性。你把一段文字切成三块，检索命中的可能只是其中一块，LLM 看到的信息是残缺的，回答自然也是残缺的。粒度选择本质上是个工程权衡，要看数据类型和查询模式，不是越细越好。</p><p>更隐蔽的一个误解是觉得 RAG 能解决所有知识问题。其实如果你想让模型学会某种风格或格式——比如用你们公司的文档风格来写东西——few-shot 或者 fine-tuning 可能更直接。RAG 解决的是”模型不知道某个事实”的问题，不是”模型不知道怎么做”的问题，这两件事的解法不该混为一谈。</p><p>搞清楚了 RAG 不是什么，接下来聊聊 RAG 怎么从”能跑”变成”能用”。这部分会比较技术，但我觉得理解每个环节的动机比记住具体方案更重要。</p><p>最朴素的 RAG——通常叫 Naive RAG——流程很简单：把文档切成固定大小的 chunk，用 embedding 模型转成向量，存进向量数据库。用户提问的时候，把问题也转成向量，用余弦相似度在向量库里找最接近的 top-K 个 chunk，拼在一起塞给 LLM，让它生成回答。</p><p>这个流程跑通不难。但跑通之后你会发现几个很具体的问题。</p><p>先说检索噪声。余弦相似度找出来的 top-10 个 chunk 里，可能只有两三个是真正相关的，剩下的只是”向量空间上离得比较近”而已。LLM 拿到一堆半相关不相关的上下文，很容易被带偏——它可能从某个噪声 chunk 里抓了一个看起来相关但已经过时的数据，然后信心满满地写进了回答。</p><p>再说 chunk 边界的问题。你按 500 个 token 切了一段文字，一个完整的论述可能被切成两半——前半段说”我们的产品分为三个版本”，后半段才展开每个版本的定价。检索只命中了前半段，LLM 根本看不到完整的信息。</p><p>更致命的是多跳问题。用户问”2024 年 Q3 我们在欧洲市场的退货率是多少”，这个回答可能需要先找到 Q3 的销售数据，再找到欧洲市场的退货统计，然后交叉计算。但 Naive RAG 只做一次检索，它大概率找到的是一份笼统的市场报告，里面的数据既不够具体也不是你要的季度。</p><p>这几个问题不是孤立的，它们指向同一个结论：Naive RAG 的瓶颈不在 LLM 的生成能力，而在检索的质量。检索垃圾进去，生成的也是垃圾。</p><p>所以从 Naive RAG 到 Advanced RAG 的演进，核心就是围绕检索的三个阶段做工程优化。</p><p>检索前的优化目标是让”问题”本身变得更适合检索。用户的原始 query 往往不是最优的检索词——用户问”怎么退货”，但你们的知识库里写的是”退换货流程与售后指引”，关键词完全不匹配。Query 改写就是用 LLM 把用户的自然语言问题转成更适合检索的形式，比如把”怎么退货”改成”退换货流程 售后指引 步骤”。</p><p>如果问题比较复杂，Query 分解会更有效——把一个复杂问题拆成多个子问题分别检索再合并。比如”对比我们三个产品的定价策略”可以拆成三个独立的检索请求。还有一个我觉得挺巧妙的技巧叫 HyDE（Hypothetical Document Embedding）：先让 LLM 根据问题”猜”一个答案，然后用这个假答案去做检索。原理很直觉——LLM 猜的答案在语义上和真实文档更接近，用答案去检索比用问题去检索效果更好。</p><p>检索环节的改进核心思路是”不要只靠一种检索方式”。向量检索擅长捕捉语义相似性——用户说”怎么退款”能匹配到”退换货流程”，因为语义上接近。但它对精确匹配不太行——用户搜一个特定的产品编号”SKU-28473”，向量检索可能完全找不到。BM25 关键词检索刚好反过来，精确匹配很强但语义理解弱。所以生产环境里最常见的做法是混合检索：向量检索和 BM25 各召回一批候选，然后合并去重。效果比单独用任何一种都好。</p><p>光召回还不够。混合检索可能召回了 50 个候选 chunk，但 LLM 的上下文窗口有限，你不可能全塞进去。所以需要重排序（Reranking）：先用一个轻量模型做粗筛，保留 20-30 个候选，再用一个更精确但更慢的 cross-encoder 模型精排，最终只保留最相关的 5-8 个。cross-encoder 的原理是同时看 query 和文档内容做注意力计算，精度比向量相似度那种”各自编码再比较”的方式高一个档次——类似招聘，先海选简历，再面试细筛。另外，元数据过滤在这一步也很关键：如果用户问的是 2024 年的政策，那 2023 年的文档直接过滤掉，不需要进入排序环节。</p><p>检索之后的事同样重要。不是所有检索结果都值得放进 LLM 的上下文。上下文压缩（Context Compression）会去掉检索结果中的冗余信息——同一件事被三份文档重复描述了，只需要保留最完整的一份。相关性校验会更进一步：用一个小模型判断每个检索结果是否真的和用户问题相关，不相关的直接丢弃。最后是引用溯源——让 LLM 在生成回答时标注每句话的来源，这样用户可以验证回答的可靠性。这一步在知识密集型场景里几乎是必须的，你不能让 Agent 给出一段无法溯源的回答，那跟幻觉没什么区别。</p><p>说到检索质量，有一个经常被低估但直接影响效果下限的决策：chunk 怎么切。</p><p>最简单的方案是固定长度切割——每 500 个 token 一刀，不管内容结构。实现起来最快，但语义很容易被切断。一个完整的操作步骤可能横跨两个 chunk，检索命中了其中一个，LLM 看到的就是不完整的指令。</p><p>更自然的做法是利用文档本身的结构信息——标题、段落、换行符——来决定切分边界。这样每个 chunk 至少是一个完整的意思，语义完整性好得多。代价是 chunk 大小不均匀，有的段落可能就两句话，有的章节可能上千字，给检索的均匀性带来一些挑战。语义切割（Semantic Chunking）的思路更精细：用 embedding 计算相邻句子的相似度，相似度突然下降的地方就说明话题切换了，那就是天然的边界。效果最好，但计算成本也最大——每句话都要算一遍 embedding。</p><p>实践中用得最多的是 LangChain 的递归切割——先按章节切，太长就按段落切，还长就按句子切，逐层往下直到大小合理。说白了就是前几种方案的组合，兼顾结构完整性和大小均匀性。</p><p>没有银弹。技术文档结构清晰，按章节切就够了；客服对话记录结构松散，可能需要语义切割；产品描述短而多，固定长度反而最简单有效。务实地说，先按段落切、跑通第一版、看检索效果，遇到具体问题再针对性优化——比一上来就追求最优解靠谱得多。</p><p>把上面这些串起来，看一个生产级的 RAG pipeline 长什么样。</p><p>场景是企业知识库问答系统。数据来源包括产品文档、内部 Wiki、技术规范、历史工单记录。用户是公司内部的客服和运营，他们需要快速查到准确的产品政策和技术参数。</p><p>整个系统分两个阶段运行。离线索引阶段：先把各种格式的文档解析成纯文本——PDF 要 OCR，Wiki 要爬取，表格要转成结构化的文字描述。然后按”段落优先、递归兜底”的策略切块。切好的 chunk 经过 embedding 模型转成向量，写入向量数据库（比如 Milvus 或 Pinecone），同时构建一份全文索引用于 BM25 检索。每个 chunk 还会附带元数据：文档标题、来源、更新时间、所属部门、权限级别。这些元数据在后面的检索过滤里会派上大用场。</p><p>在线查询阶段的流程大致是这样：</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br><span class="line">28</span><br><span class="line">29</span><br><span class="line">30</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">def</span> <span class="title function_">rag_pipeline</span>(<span class="params">query: <span class="built_in">str</span>, user_context: <span class="built_in">dict</span></span>) -&gt; Answer:</span><br><span class="line">    <span class="comment"># 1. Query 改写：把口语化的问题转成结构化检索词</span></span><br><span class="line">    rewritten_query = query_rewriter.rewrite(query)</span><br><span class="line"></span><br><span class="line">    <span class="comment"># 2. 混合检索：向量 + BM25，各召回 top-20</span></span><br><span class="line">    vector_results = vector_store.search(rewritten_query, top_k=<span class="number">20</span>)</span><br><span class="line">    bm25_results = bm25_index.search(rewritten_query, top_k=<span class="number">20</span>)</span><br><span class="line">    candidates = merge_and_dedup(vector_results, bm25_results)</span><br><span class="line"></span><br><span class="line">    <span class="comment"># 3. 元数据过滤：按时间、来源、权限缩小范围</span></span><br><span class="line">    candidates = metadata_filter(</span><br><span class="line">        candidates,</span><br><span class="line">        time_range=user_context.get(<span class="string">&quot;time_range&quot;</span>),</span><br><span class="line">        department=user_context.get(<span class="string">&quot;department&quot;</span>),</span><br><span class="line">        access_level=user_context.get(<span class="string">&quot;access_level&quot;</span>),</span><br><span class="line">    )</span><br><span class="line"></span><br><span class="line">    <span class="comment"># 4. 重排序：cross-encoder 精排，保留 top-5</span></span><br><span class="line">    ranked_results = reranker.rerank(query, candidates, top_k=<span class="number">5</span>)</span><br><span class="line"></span><br><span class="line">    <span class="comment"># 5. 上下文组装：去重、压缩、拼接</span></span><br><span class="line">    context = context_compressor.compress(ranked_results)</span><br><span class="line"></span><br><span class="line">    <span class="comment"># 6. LLM 生成：基于上下文回答问题</span></span><br><span class="line">    answer = llm.generate(query=query, context=context)</span><br><span class="line"></span><br><span class="line">    <span class="comment"># 7. 引用标注：给回答中的每个断言标注来源</span></span><br><span class="line">    cited_answer = citation_annotator.annotate(answer, ranked_results)</span><br><span class="line"></span><br><span class="line">    <span class="keyword">return</span> cited_answer</span><br></pre></td></tr></table></figure><p>这里有几个值得说的工程决策。为什么选混合检索而不是纯向量？因为企业知识库里大量查询是精确匹配的——员工搜一个具体的产品型号或政策编号，BM25 比向量检索靠谱得多。为什么用 cross-encoder 重排序而不是直接用向量相似度？因为 cross-encoder 是交叉编码，会同时看 query 和文档内容做注意力计算，精度比”各自编码再比较”高一个档次。代价是慢，所以只对粗筛后的少量候选做精排，把延迟控制在可接受的范围。至于为什么按段落切而不是语义切割——其实产品文档结构清晰的时候，段落本身就是很好的语义边界，没必要引入额外的 embedding 计算成本。</p><p>性能和成本的权衡贯穿始终。Query 改写和 HyDE 都要额外调一次 LLM，重排序要跑 cross-encoder——每一层都增加延迟和成本。如果查询量不大、对延迟不敏感，全上没问题。但如果是高并发的在线服务，就得做取舍：Query 改写保留，HyDE 砍掉；粗筛用向量相似度代替 cross-encoder 的第一轮；上下文压缩用简单的去重代替 LLM 摘要。说白了，不是所有环节都需要最贵的方案，够用就行。</p><p>回到 Agent 的视角来看 RAG。</p><p>RAG 不是一个独立系统，它是 Agent 的知识基础设施。上一篇我们聊了 Agent 的骨架——LLM 负责推理，Tools 负责执行，Memory 负责记忆，Harness 负责安全。RAG 解决的是另一个维度的问题：Agent 的推理需要事实依据，而这些事实不可能全靠训练数据来提供。</p><p>可以用一个简单的分工来理解它们的关系。Agent 是执行者，决定做什么、怎么做。RAG 是知识源，在 Agent 需要事实依据的时候提供弹药。Harness 是安全网，确保 Agent 的行为在可控范围内。三层缺一不可：没有 RAG 的 Agent 是一个不知道任何业务事实的工具执行器，没有 Harness 的 Agent 是一个不可控的风险源。</p><p>那 Agent 什么时候该用 RAG？简单说，当任务需要”知道某个具体事实”的时候——查政策、找参数、定位文档。需要”执行某个操作”的时候该用工具——发邮件、查数据库、调用 API。需要”回忆之前做过什么”的时候该用记忆——追踪任务进度、延续对话上下文。三种信息来源各有边界，搞混了效果就差。</p><p>单个 Agent 配上 RAG 和 Harness，已经能做不少事了。但现实世界里的任务往往不是单个 Agent 能扛住的——一个复杂的企业流程可能涉及多个系统的交互、多种角色的协作、多个阶段的串并联。单个 Agent 再强，也有天花板。下一篇我们就聊聊，当天花板真的撞到了，怎么通过多 Agent 编排来突破它。</p><p>RAG 的核心从来不是接个向量数据库。从 Query 理解到检索策略、从 Chunk 切分到重排序、从上下文组装到引用溯源——每一个环节都在做同一件事：让 LLM 拿到最好的素材，然后生成最准确的回答。素材质量决定了回答质量的上限，而每个工程环节都在往上推这个上限。</p><p>当然，并不是每个场景都需要全套组件。先跑通 Naive RAG，有了基线数据，再根据具体问题逐个优化。检索噪声大就加重排序，语义切断就调 Chunk 策略，多跳问题就加 Query 分解。不要一上来就把所有高级组件全堆上去——每一层都有成本，每一层都可能引入新的 bug。<strong>先让它跑起来，再让它跑得好</strong>。</p><p>这说到底是个工程问题，不是什么魔法。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2026/06/06/Agent%E5%B7%A5%E7%A8%8B%E5%8C%96%EF%BC%88%E4%BA%8C%EF%BC%89RAG%E4%B8%8D%E6%98%AF%E6%90%9C%E7%B4%A2/</id>
    <link href="https://maybejustlikethis.github.io/2026/06/06/Agent%E5%B7%A5%E7%A8%8B%E5%8C%96%EF%BC%88%E4%BA%8C%EF%BC%89RAG%E4%B8%8D%E6%98%AF%E6%90%9C%E7%B4%A2/"/>
    <published>2026-06-05T16:00:00.000Z</published>
    <summary>纠正&quot;RAG 就是搜索&quot;的误解，展示从 Naive RAG 到生产级 RAG pipeline 的完整演进路径</summary>
    <title>Agent 工程化（二）：RAG 不是搜索——让 Agent 真正&quot;懂&quot;你的数据</title>
    <updated>2026-10-19T15:31:12.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/categories/%E6%9D%82%E8%B0%88/"/>
    <category term="旅行" scheme="https://maybejustlikethis.github.io/tags/%E6%97%85%E8%A1%8C/"/>
    <content>
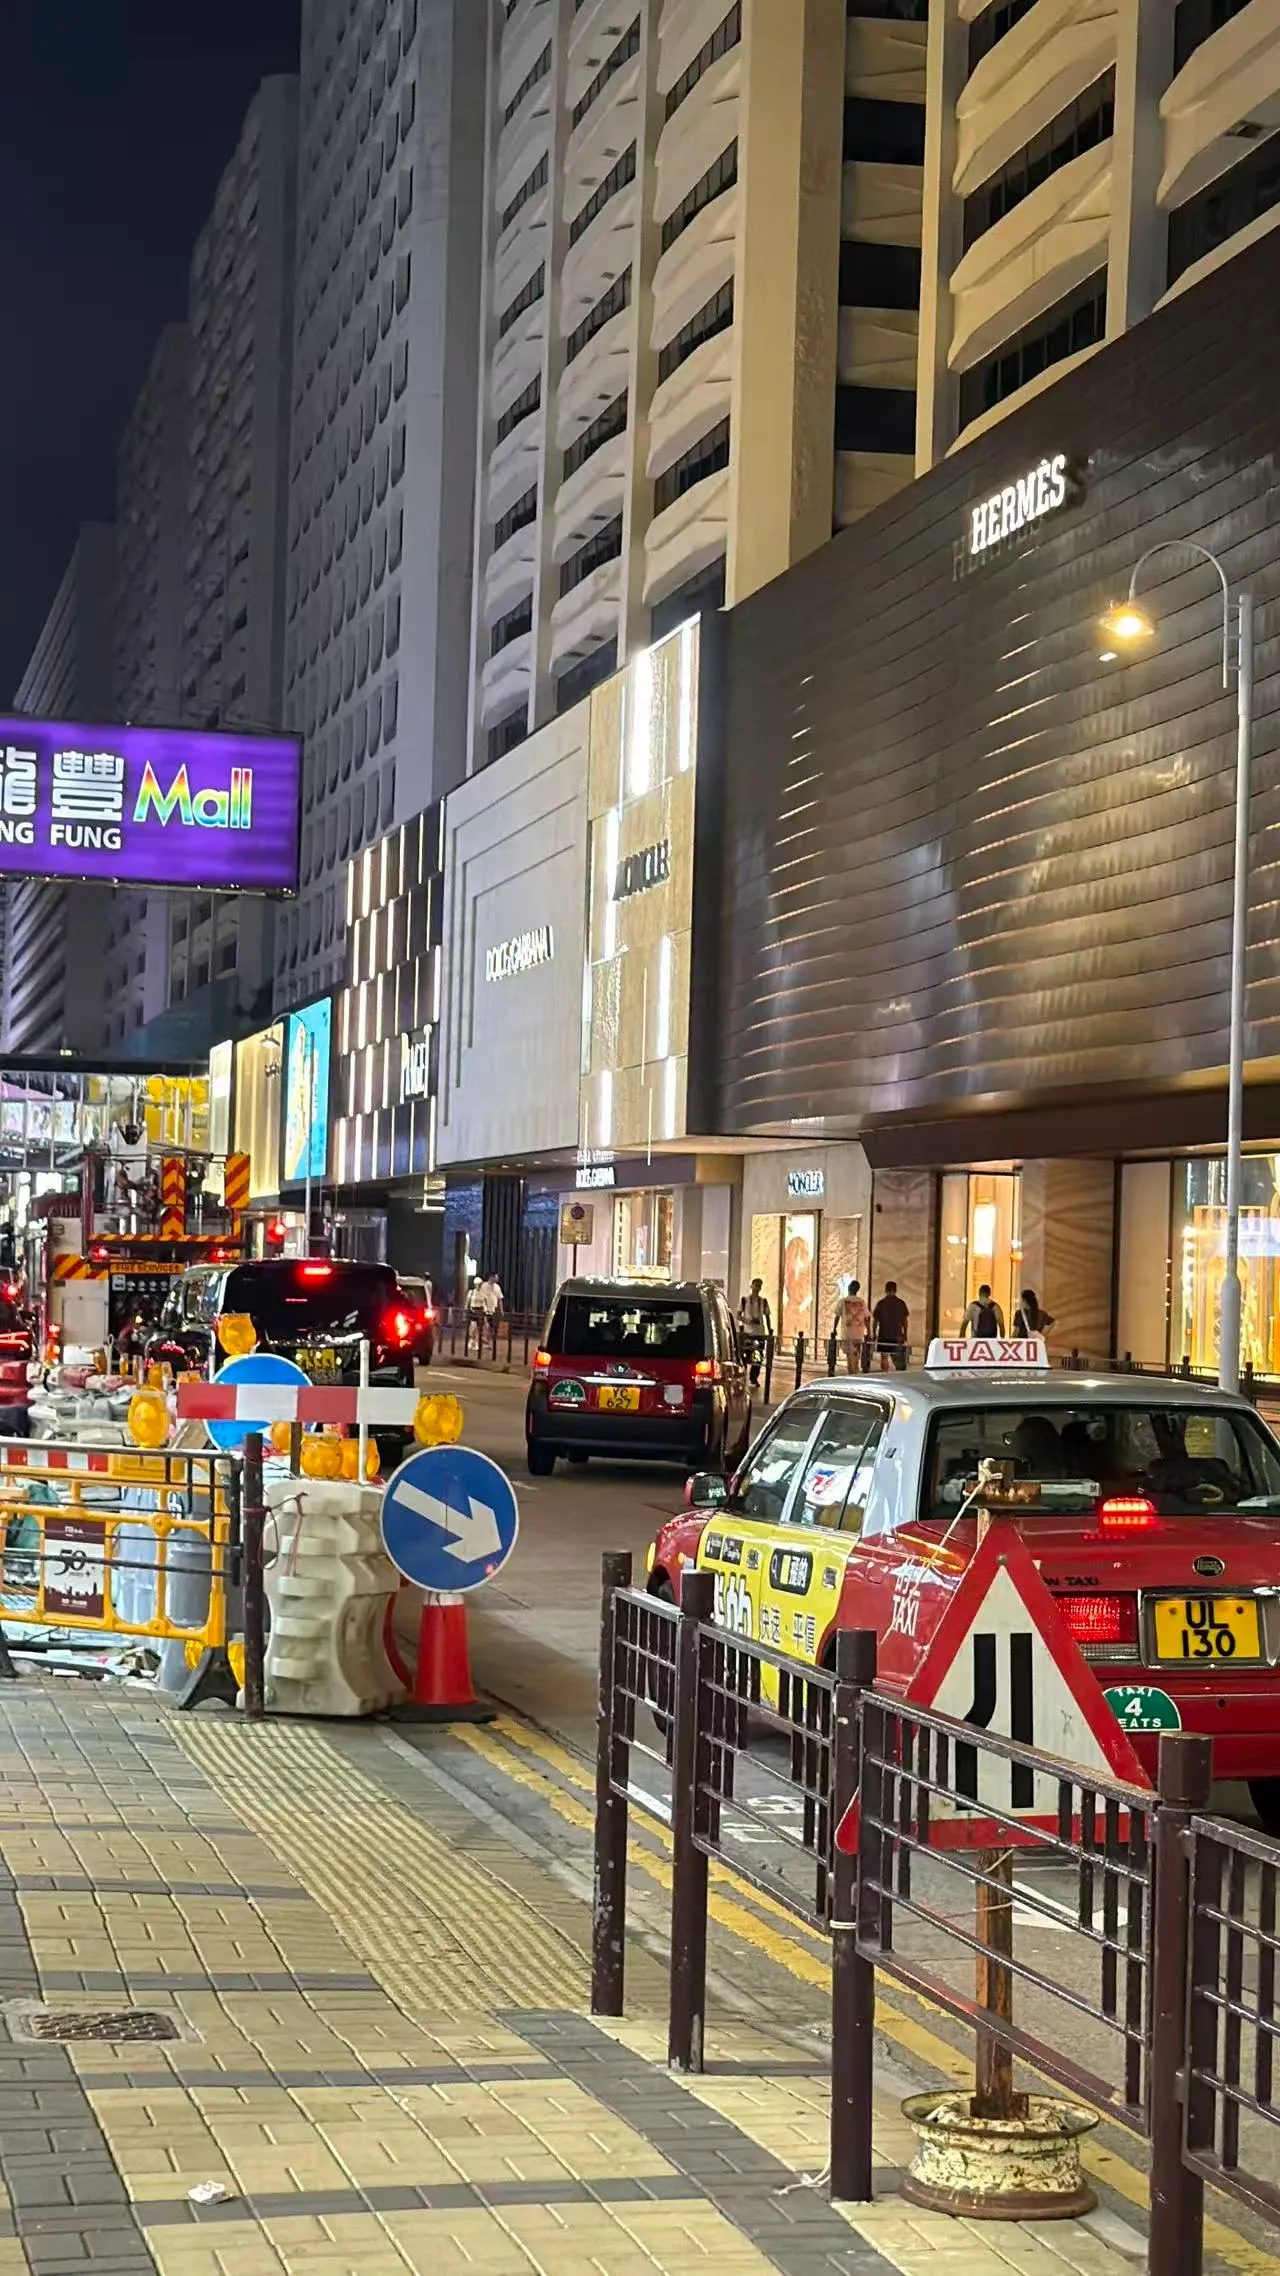
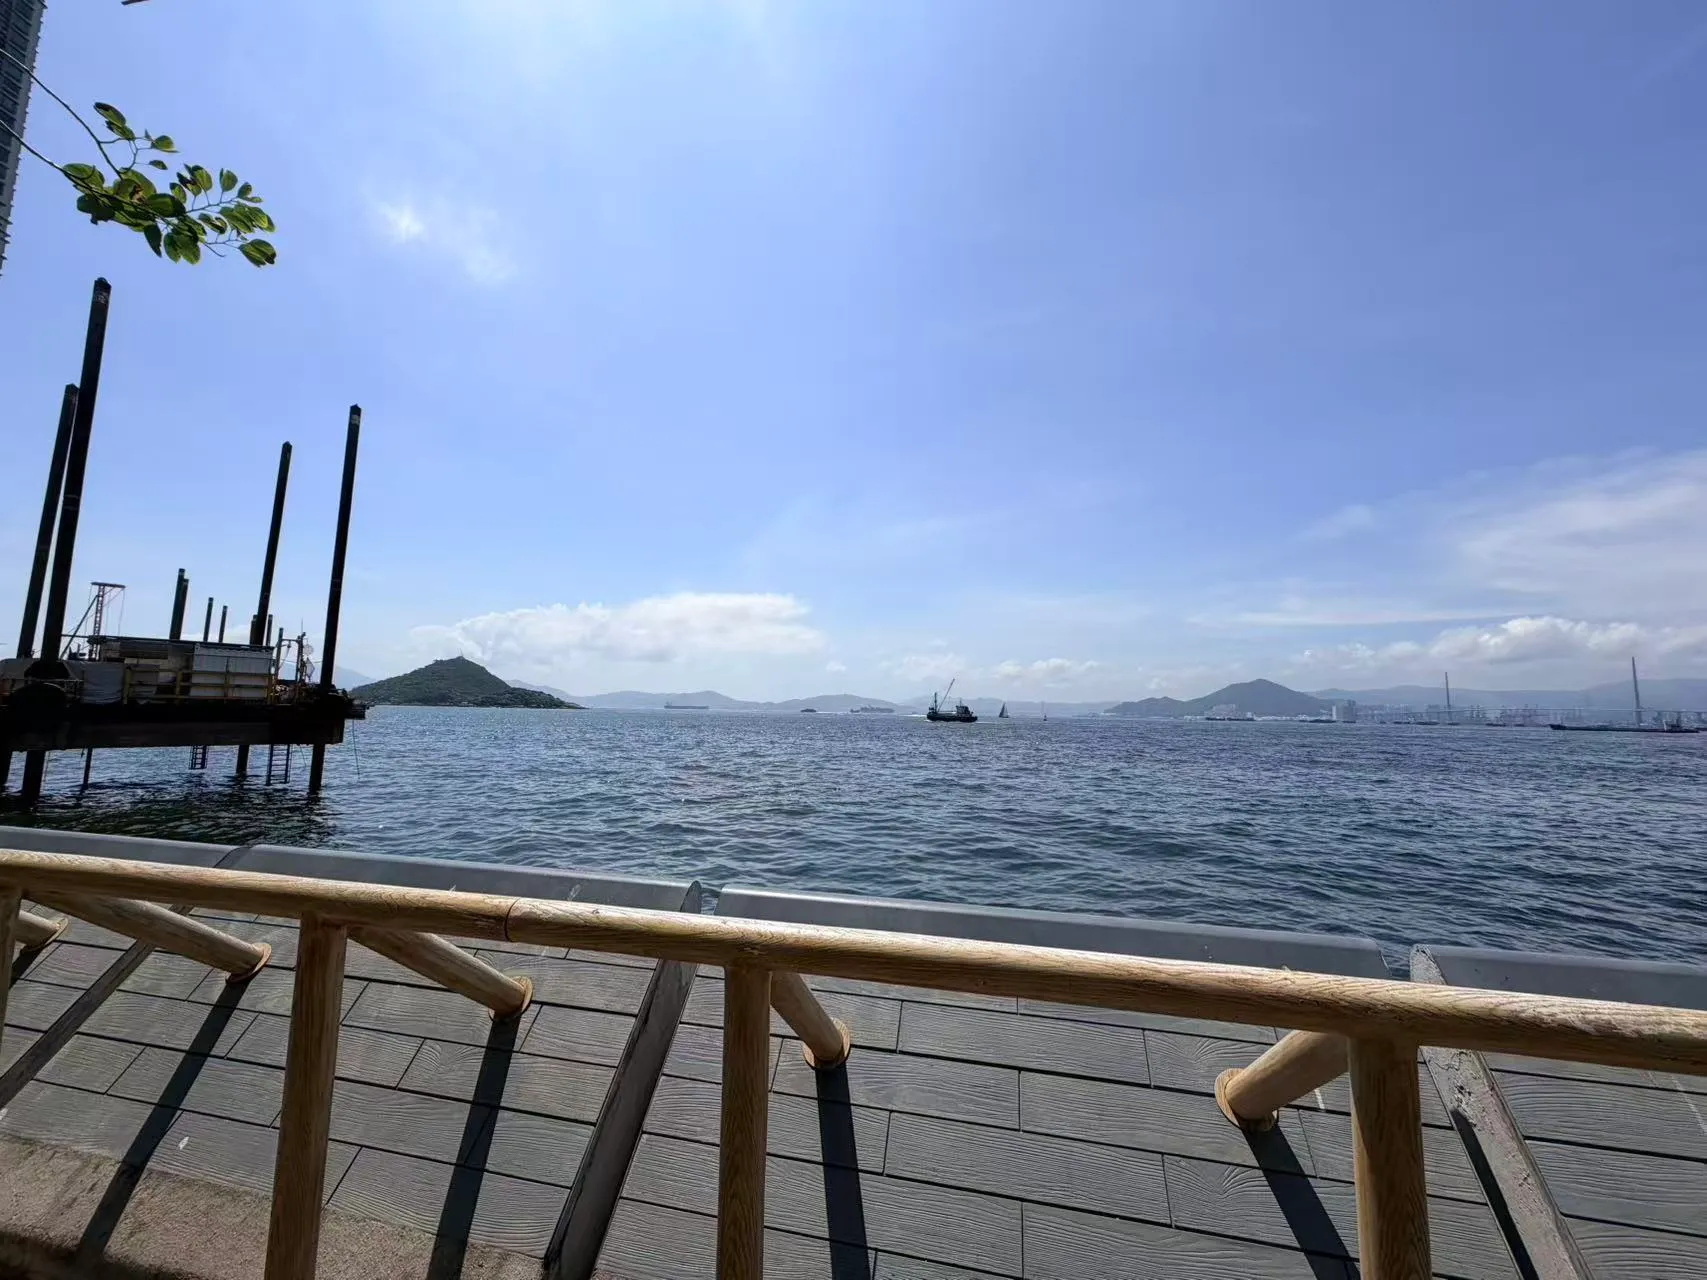
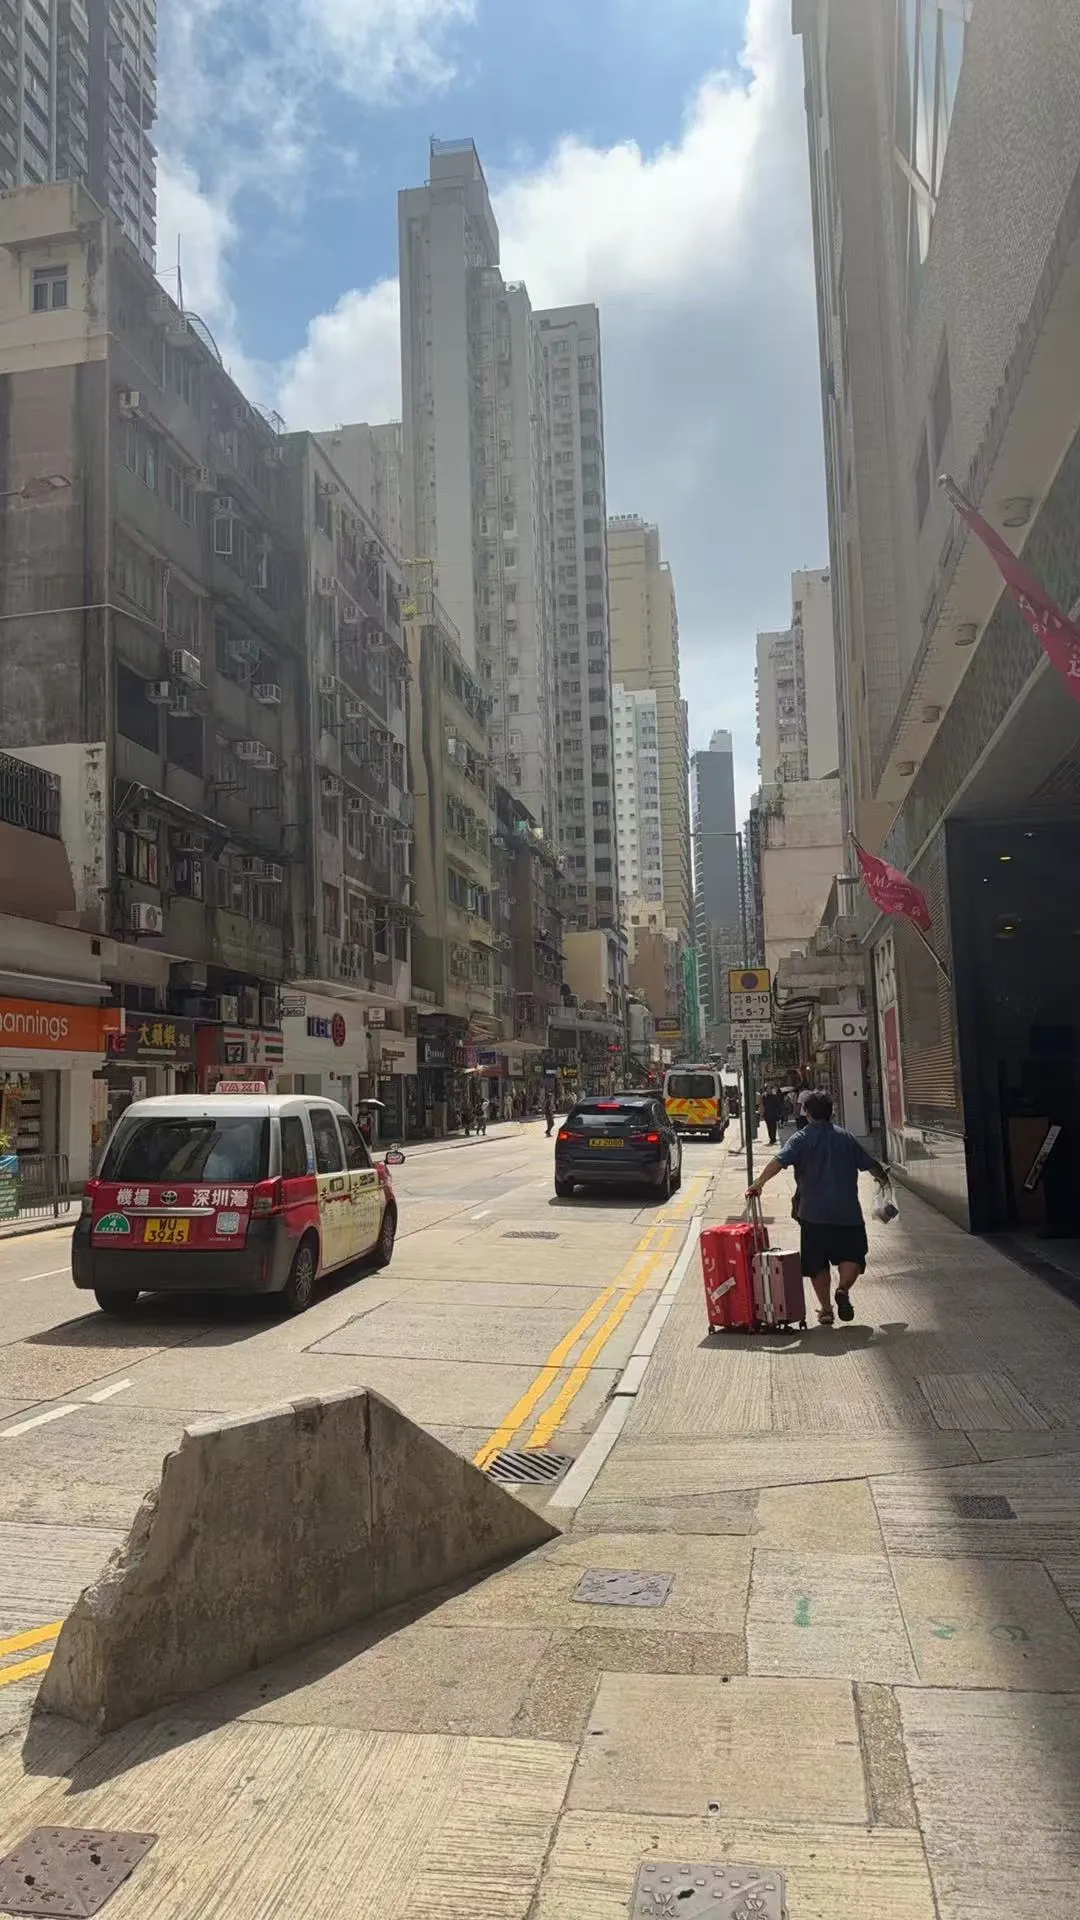
      <![CDATA[<h1 id="香港之行"><a href="#香港之行" class="headerlink" title="香港之行"></a>香港之行</h1><blockquote><p>有些地方，你去了之后才明白为什么那么多人想去。</p></blockquote><p>五月底，趁着毕业前的空档，和一个朋友约了趟香港。从太原出发，经昆山、宁波，上海、香港、澳门，最后从珠海飞回——五天四城，行程紧凑得像在跑一场接力赛。</p><h2 id="路线"><a href="#路线" class="headerlink" title="路线"></a>路线</h2><p>整趟行程大概是这样的：先从太原到昆山短暂中转，然后坐火车到宁波玩了两天，然后火车去上海浦东，第二天一早飞香港。在香港待两晚，坐大巴去澳门住一晚，最后从珠海飞回。</p><p>这趟行程最折腾的是交通——火车、飞机、大巴、轻轨全凑齐了。但说实话，<strong>穷学生嘛，折腾才是常态</strong>。</p><h2 id="宁波"><a href="#宁波" class="headerlink" title="宁波"></a>宁波</h2><p>在去上海之前，先在宁波停了两天，和东哥、谷哥、超哥碰了面。几个人好久没聚，一见面就是熟悉的互损模式，好像从来没分开过一样。</p><p>去了<strong>天一阁</strong>，说是中国现存最老的私家藏书楼，始建于明朝嘉靖年间。走进去的第一感觉不是”哇好多书”，而是——安静。院子里的树很老，石板路被磨得发亮，空气里有一种旧书和木头混在一起的味道。范钦当年建这个藏书阁的时候立了条规矩——“代不分书，书不出阁”，意思就是书是家族的共同财产，谁也不能拿走。几百年下来，战乱、火灾、盗窃都没能把它毁掉，这份对书的执念，放在今天来看简直是不可思议的。</p><p><strong>其实最让我感慨的不是书，而是”守”。</strong> 范家十几代人守着一座楼、一堆书，一代一代传下来。我们这代人习惯了快——快节奏、快消费、快速遗忘——突然看到一样东西被守了几百年，心里会有一种说不清的触动。不是感动，更像是”原来还可以这样活着”的愣住。</p><p>从天一阁出来，几个人在宁波街头瞎逛，吃了一顿海鲜大排档，聊到很晚。具体聊了什么已经记不清了，但那种感觉——<strong>朋友在身边、接下来还有一整趟旅行在等着你</strong>——大概是毕业季最奢侈的东西了。</p><p><img src="/2026/05/30/%E9%A6%99%E6%B8%AF%E4%B9%8B%E8%A1%8C/%E5%A4%A9%E4%B8%80%E9%98%81.webp"></p><h2 id="香港"><a href="#香港" class="headerlink" title="香港"></a>香港</h2><p>来之前对香港的想象基本来自港片——霓虹灯、窄街道、维港夜景。到了之后发现，港片没骗人，但也没说全。</p><p><strong>维多利亚港</strong>是一定要去的。站在星光大道上往对岸看，中环的高楼像是从水里长出来的，到了晚上灯亮起来，确实有一种说不清的震撼。</p><p><img src="/2026/05/30/%E9%A6%99%E6%B8%AF%E4%B9%8B%E8%A1%8C/%E7%BB%B4%E5%A4%9A%E5%88%A9%E4%BA%9A%E6%B8%AF%E5%A4%9C%E6%99%AF.webp"></p><p>不是那种”哇好美”的震撼，而是——“原来这就是香港啊”——一种终于亲眼看见了的确认感。</p><p>维多利亚港夜景，另一个角度：</p><p><img src="/2026/05/30/%E9%A6%99%E6%B8%AF%E4%B9%8B%E8%A1%8C/%E7%BB%B4%E5%A4%9A%E5%88%A9%E4%BA%9A%E6%B8%AF%E5%A4%9C%E6%99%AF-2.webp"><br><img src="/2026/05/30/%E9%A6%99%E6%B8%AF%E4%B9%8B%E8%A1%8C/%E7%BB%B4%E5%A4%9A%E5%88%A9%E4%BA%9A%E6%B8%AF%E5%A4%9C%E6%99%AF-3.webp"></p><p>从维港往北走几步就是<strong>尖沙咀</strong>，奢侈品店一家挨着一家，橱窗亮得晃眼。倒不是去买什么——就是看看，看看这座城市的另一面。</p><p><img src="/2026/05/30/%E9%A6%99%E6%B8%AF%E4%B9%8B%E8%A1%8C/%E5%B0%96%E6%B2%99%E5%92%80%E5%A5%A2%E4%BE%88%E5%93%81%E4%B8%80%E6%9D%A1%E8%A1%97.webp"></p><p><strong>太平山顶</strong>的缆车值得一坐。坡度陡到你会以为自己在坐过山车，整座城市在身后慢慢倾斜。山顶的风很大，五月底的香港已经很热了，但山顶的风吹着很舒服。</p><p>比较遗憾的是没走成<strong>麦理浩径</strong>。这条徒步路线据说是香港最美的海岸线之一，但因为时间太紧，只走到了标距柱那边看了一眼。<strong>下次一定。</strong></p><p>白天在港岛西边逛了逛<strong>坚尼地城</strong>，这边游客少了很多，街巷安静，能闻到海风混着市井的味道。</p><p><img src="/2026/05/30/%E9%A6%99%E6%B8%AF%E4%B9%8B%E8%A1%8C/%E5%9D%9A%E5%B0%BC%E5%9C%B0%E5%9F%8E.webp"></p><p>住的地方在<strong>皇后大道西</strong>，楼下就是老城区，说不上多方便，但胜在有烟火气。</p><p><img src="/2026/05/30/%E9%A6%99%E6%B8%AF%E4%B9%8B%E8%A1%8C/%E7%9A%87%E5%90%8E%E5%A4%A7%E9%81%93.webp"><br><img src="/2026/05/30/%E9%A6%99%E6%B8%AF%E4%B9%8B%E8%A1%8C/%E4%B8%8B%E6%A6%BB%E7%9A%84%E9%85%92%E5%BA%97.webp"></p><p>在香港吃了两顿<strong>茶餐厅</strong>，冻柠茶和菠萝油，没有刻意找网红店，路边随便进的。味道说不上惊艳，但那种老派的氛围——瓷砖墙、卡座、伙计不耐烦的语气——本身就是一种体验。</p><p><img src="/2026/05/30/%E9%A6%99%E6%B8%AF%E4%B9%8B%E8%A1%8C/%E6%B8%AF%E5%BC%8F%E8%8C%B6%E9%A4%90%E5%8E%85.webp"></p><h2 id="澳门"><a href="#澳门" class="headerlink" title="澳门"></a>澳门</h2><p>香港到澳门坐船，大概一个小时就到了。澳门跟香港是完全不同的气质——香港是快的、挤的、向上的，澳门是慢的、散的、躺平的。</p><p>澳门的酒店（澳门金宝来酒店）在氹仔，位置偏了点，但胜在安静。市区里到处是葡式建筑和老街巷，走几步就能闻到蛋挞味。<strong>赌场当然也去看了一眼</strong>，美高梅的奶茶和小吃很好吃。金碧辉煌到让人觉得不真实，但也就是看看而已——毕竟预算不允许别的操作。</p><h2 id="几个实用建议"><a href="#几个实用建议" class="headerlink" title="几个实用建议"></a>几个实用建议</h2><p>如果以后你也打算去，这几件事可以提前弄好：</p><ul><li><strong>八达通</strong>：Apple 钱包可以直接申请，50 港币押金，地铁和便利店都能用。比每次买票方便太多</li><li><strong>流量</strong>：提前开好手机卡的漫游套餐，别到了再弄，香港机场的 wifi 可以临时使用</li><li><strong>港币现金</strong>：虽然支付宝微信在很多地方能用，但路边小店和部分餐厅还是只收现金，换几百块傍身比较安心</li><li><strong>港卡</strong>：如果想办香港银行卡，汇丰 One（红狮子储蓄卡 + 蓝狮子借记卡）门槛最低；众安银行和天星银行可以线上开；中银香港比较难搞，随缘就好</li></ul><h2 id="写在最后"><a href="#写在最后" class="headerlink" title="写在最后"></a>写在最后</h2><p>这趟旅行有一个意外的收获：<strong>第一次直观地感受到了两种社会制度下的生活差异。</strong></p><p>香港的阶级分层是肉眼可见的。中环的写字楼里走出来的人西装革履，半山上的房子一平米几十万港币；而深水埗的菜市场里，老人家弯着腰捡菜叶，笼屋里的床位一个月也要两三千。路过一家房产中介的时候瞄了一眼——400 平方英尺（大概不到 40 平米）的房子，月租金 15000 港币起步，售价动辄几百万。我当时站在橱窗前算了好一会儿，确认自己没有少看一个零。</p><p>但另一方面，香港的社会福利也确实比内地好。普通服务员月薪 15000-25000 港币，公立医院看病几乎免费，综援（相当于低保）覆盖得比内地全面。街上的残疾人设施、无障碍通道比内地大多数城市都完善。<strong>穷人过得比内地的穷人好，但穷人也比内地的穷人更绝望</strong>——因为这里的房价让你无论如何努力，都可能永远买不起一个像样的住处。</p><p>资本主义的答案很诚实：它不骗你”共同富裕”，它直接把规则摆在那里。你能爬多高算你的本事，跌下来也不会有人接。<strong>自由是真的，代价也是真的。</strong></p><p>但这趟旅行本身其实没什么戏剧性——就是走了一些地方，看了一些风景，和朋友随便聊了些有的没的。宁波的天一阁、香港的维港、澳门的赌场，说到底都只是背景。真正留在记忆里的，是和朋友互损时笑出来的眼泪，是在茶餐厅喝到第一口冻柠茶时的满足，是在维多利亚港吹着风发呆的那几分钟。</p><p>在珠海机场候机的时候，我在想：也许旅行的意义不是”去了哪里”，而是”离开了一下”。离开日常的生活轨道，离开那些让你焦虑的事情，哪怕只是几天，回来之后好像什么都会好一点。</p><p>到此为止了。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2026/05/30/%E9%A6%99%E6%B8%AF%E4%B9%8B%E8%A1%8C/</id>
    <link href="https://maybejustlikethis.github.io/2026/05/30/%E9%A6%99%E6%B8%AF%E4%B9%8B%E8%A1%8C/"/>
    <published>2026-05-30T04:00:00.000Z</published>
    <summary>五天四城，从昆山到香港澳门，一场说走就走的毕业旅行</summary>
    <title>香港之行</title>
    <updated>2026-05-31T04:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/categories/%E6%9D%82%E8%B0%88/"/>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/tags/%E6%9D%82%E8%B0%88/"/>
    <content>
      <![CDATA[<h1 id="善护念：自我管理，管的是念头"><a href="#善护念：自我管理，管的是念头" class="headerlink" title="善护念：自我管理，管的是念头"></a>善护念：自我管理，管的是念头</h1><blockquote><p>“云何应住，云何降伏其心？” —— 《金刚经》</p></blockquote><p>须菩提问佛陀：云何应住，云何降伏其心——这颗心，到底该怎么安放，怎么降伏？问完之后，他自己加了一句赞叹：”如来善护念诸菩萨，善付嘱诸菩萨。”</p><p>佛陀开口说的第一句话，不是道理，不是法门，而是一句看似什么都没说的回答：”善男子、善女人，发阿耨多罗三藐三菩提心，<strong>应如是住，如是降伏其心。</strong>“</p><p>应如是住，如是降伏其心——就这样安住，就这样降伏你的心。</p><p>你刚才聚精会神问我的时候，你的心不就是安住的吗？它不就是降伏的吗？<strong>答案已经在你身上了。</strong> 须菩提没有意识到，他在恭敬合掌、专注提问的那个时刻，心念已经很自然地”住”在了那个当下。不需要额外来一个方法，不需要另外找一个技巧。能听到自己的一呼一吸，能问出一句真心想问的话，那种”完全在听、完全在问”的专注，这件事情本身就是答案。</p><p>然后佛陀才开始展开后面一切——人相我相、不住布施、凡所有相皆是虚妄、应无所住而生其心——在”如是”的基础上搭出了整部《金刚经》。落到最实处的就是那四个字，<strong>应无所住而生其心</strong>。惠能当年在客店听见有人念这句，当场就悟了。</p><p>后来南怀瑾说，佛陀讲了这么多，但真正在操作层面，能让一个普通人每天下手去做的功夫是什么？他把眼光落回了须菩提那句赞叹里的三个字：<strong>善护念</strong>。他说不管儒家、佛家、道家，人类一切的修养方法，归根到底都是这三个字。好好照应你的心念。起心动念，都要好好照应。</p><p>这三个字我最早看到的时候没什么感觉，觉得不过是一句正确的古话。直到有一次我在书桌前试图啃一本专业书，十分钟后我的手不知道什么时候已经拿起了手机，大拇指在自动下滑，而我完全不记得自己拿起手机的动作。那个瞬间我突然意识到——什么叫没有善护念？这个就叫没有善护念。我的念被手机牵走了，不是我去拿的手机，是念头推着我去的。<strong>我根本没有在管我的念头。我的念头在被算法管。</strong></p><p>顺着这个思路想下去，我发现了一件事：我们通常以为自我管理管的是时间、管的是行为、管的是习惯。但你仔细想一下，你早上列了八个待办事项，为什么到晚上只划掉了两个？你设了屏幕使用时间限制，为什么每次弹出提醒的时候你都点了”忽略”？明明知道该做什么，为什么身体就是不动？</p><p><strong>不是时间管理出了问题，是念头管理出了问题。</strong></p><p>你计划好要看一小时书，然后”看一下手机休息五分钟”这个念头出现了。你响应了它。然后一个半小时过去了。在这个过程里，时间表没有变，行为上的”计划”也没有变，变的是——<strong>一个念头来了，你跟着它走了，你没有护住这个念。</strong></p><p>所以善护念不是一个宗教概念。它是对自我管理最精确的诊断：你管不住那一个个在脑子里冒出来的念头，你就管不住你的行为；你管不住行为，你就管不住你的生活。</p><p>这听起来很简单，好像是个人都懂的道理。但有意思的是，人类历史上最会自我管理的那些人，他们的整个系统归结到底，干的都是同一件事——护念。</p><p>曾国藩这个人特别适合拿出来讲，因为他起点太普通了。</p><p>考了七次才中进士。年轻的时候毛病一大堆：浮躁、好色、爱凑热闹、说话刻薄、烟瘾极大。他自己在日记里写，去朋友家做客，看见朋友的小妾长得漂亮，”目屡邪视”，回家后在日记里把自己骂了一通——“直不是人，耻心丧尽，更问其他？”这不是作秀。这是他发自内心的自我审判。你读他早年的日记，几乎每一页都有人在骂自己——今天某句话不该说，今天某个念头不该起，今天又在某件事上放纵了自己。</p><p>三十岁那年，他决定从头做人。拜唐鉴、倭仁为师，学理学，立下了著名的<strong>日课十二条</strong>。我把这十二条抄出来，你感受一下它的密度——</p><p><strong>主敬</strong>，整齐严肃，无事时心在腔子里，应事时专一不杂。<strong>静坐</strong>，每日不拘何时，静坐四刻，如鼎之镇。<strong>早起</strong>，黎明即起，醒后勿沾恋。<strong>读书不二</strong>，一书未完，不看他书。<strong>读史</strong>，二十三史每日圈点十页，虽有事不间断。<strong>谨言</strong>，刻刻留心，第一功夫。<strong>养气</strong>，气藏丹田，无不可对人言之事。<strong>保身</strong>，节劳节欲节饮食。<strong>日知所亡</strong>，每日读书记录心得语。<strong>月无忘所能</strong>，每月作诗文数首。<strong>作字</strong>，早饭后写字半小时。<strong>夜不出门</strong>，旷功疲神，切戒切戒。</p><p>写计划谁都会。曾国藩真正恐怖的地方在于——<strong>这十二条，他从三十岁开始执行，一直执行到死在任上，前后三十多年。</strong> 不是做做样子，不是三天打鱼两天晒网，是真的每天都在做。</p><p>他怎么做到的？核心机制就是他的日记。</p><p>曾国藩的日记不是简单的流水账。他把日记当成”自讼”的工具——自己是被告，日记是法官。每天晚上，他把当天每一个过失记录下来，不只是行为上的过失，更重要的是<strong>念头上的过失</strong>。起了贪念，写下来骂自己。起了淫念，写下来骂自己。说过一句刻薄话，写下来骂自己。这个操作被称为”研几”——把每一个细微的念头放在放大镜下审视。而且他不只是自己看。他把日记抄成多份，送给师友批阅。倭仁、唐鉴这些人在他的日记上写批注，批评他哪里没做好，告诉他该怎么改。曾国藩管这叫**”师友夹持”**——他知道自己一个人的意志力不够用，所以他从外部为自己的念头搭了一个牢笼。</p><p>你对比一下现代人的处境就很有意思了。曾国藩是自己主动把日记送给别人批阅——他主动为自己的念头向外暴露，用外部监督来约束内部松散。而我们现在是反过来：算法主动侵入你的念头空间，用外部刺激来瓦解内部控制。曾国藩求着被人管，我们是被别人偷着管。</p><p>他一生最推崇的一个字叫**”恒”**。他说：”学问之道无穷，而总以有恒为主。”恒不是天赋。恒是每天和昨天的自己打同一场仗——把四散的念头一次次拉回到该在的地方。你去看他在军营里的作风：每日天未明即起，与幕僚共进早餐，饭后处理军务、阅读、会客，几十年节奏不变。一个人能把散乱念头管住三十年，他就没有管不住的事了。</p><p>比曾国藩晚一个世纪，地球另一边，本杰明·富兰克林在做一件几乎一模一样的事。</p><p>富兰克林也是从底层硬生生把自己锻造成材的人。他在自传里详细记录了自己设计的一套自我管理系统——<strong>13 项美德养成计划</strong>：节制、缄默、秩序、决心、节俭、勤勉、诚恳、公正、中庸、清洁、平静、贞洁、谦卑。每项附一句简短规诫，比如”秩序”就是”让每样东西各有其位，让每件事各有其时”。</p><p>他的执行方式像个工程师。他做了一本小册子，红笔画了 7 条竖线代表一周七天，13 条横线代表 13 项美德，形成一个矩阵。每天晚上，检查当天在哪项美德上犯了错，在对应格子里画一个小黑点。策略是<strong>每周只重点攻克一项美德</strong>，其余十二项只做一般记录。13 周走完一轮，重新开始，一年循环四次。他的逻辑很朴素——园丁不可能一次除掉花园里所有杂草，只能一个花坛一个花坛地锄。他知道一个人的管控带宽有限，不能同时打十三场仗。</p><p>但这本书被很多人当成工具书来读，我自己读到他最初的意图时其实愣了一下——他搞这套系统的出发点不仅仅是”我想变好”，更深层的原因是他在乎自己的<strong>信念一致性</strong>。他年轻时开印刷所，因为性格散漫、说话冲，常常得罪客户和同事。而他需要这些人信任他的品格，才能在商场上站稳。所以 13 美德的实质是一套信用基础设施，是让他的行为和他想建立的社会形象对齐。</p><p>这就更有意思了——一个十八世纪的人，在没有任何心理学工具的情况下，自己把行为追踪、习惯养成、印象管理三件事合在一起做成了一套系统。而这一切的操作对象是什么？还是念头。每天晚上画黑点的那个动作，本质上是一次<strong>念头的审计</strong>——我今天哪里让念头做主了？我今天在哪项美德上摔了跤？</p><p>富兰克林自己后来说，他从来没有完全达到这十三项美德的完美标准，但这套系统让他成为了一个远比原来好的人。他从一个穷小子白手起家，最终成了科学家、外交家、开国元勋，横跨了公共生活的每一个领域。他归因于这套系统。这里面最触动我的不是方法本身，而是一个细节——<strong>他从二十岁开始做这件事，做了一辈子。</strong> 这和曾国藩完全是同一种模式：不是天赋，不是顿悟，是持续的、日复一日的念头管理。曾国藩用内省日记，富兰克林用功过格，操作界面不一样，底层逻辑一模一样。你每天审视一下你今天被哪些念头推着走了，然后明天少被推走一次。这听起来不酷，但它有效。</p><p>如果说曾国藩偏”克己”，富兰克林偏”系统”，那王阳明提供的是一条更底层的路线——<strong>事上磨练</strong>。</p><p>他的弟子陆澄问过他一个问题，这个问题放到今天就是一个典型的自我管理困境：”我静坐的时候感觉自己状态很好，很专注很平静，但是一遇到具体的事情，就全乱了。怎么办？”</p><p>王阳明的回答是：”<strong>是徒知静养而不用克己工夫也。如此临事便要倾倒。人须在事上磨，方立得住，方能静亦定，动亦定。</strong>“翻译成大白话就是——你只是在安静的时候觉得岁月静好，没用的，你必须是那个在风暴里还站得住的人。在事上磨，磨的就是那颗被事情牵着跑的心。</p><p>他还有一句话更狠：”<strong>持志如心痛。一心在痛上，岂有工夫说闲话，管闲事。</strong>“你的志向应该像你身上的痛一样，你随时都能感觉到它，你不可能因为刷了个短视频就忘了你在痛。如果你的”志”能被一条推送打断，那不是志向，那是幻觉。</p><p>他在江西讲学的时候，有个司法官员来听讲，抱怨说公务太忙没时间学习。王阳明直接告诉他：”<strong>我何尝教尔离了簿书讼狱，悬空去讲学？尔既有官司之事，便从官司的事上为学，才是真格物。</strong>“你不是没时间修行，你的工作本身就是修行。一个案子审下来——不能因为对方语无伦次就起怒心，不能因为对方花言巧语就起喜心，不能因为对方送礼就偏袒，不能因为案子太多就潦草结案。<strong>每一个审理时刻，都是善护念的时刻。</strong></p><p>这个视角非常厉害。它把”自我管理”从一项额外任务变成了一个无处不在的场。你不需要专门腾出一小时冥想，你每一分钟都在冥想——只是你自己不知道。你在回复一封让人火大的邮件，那个火大的念头来了，你跟不跟它走？这就是自我管理。你在开会，无聊感涌上来了，你是打开手机刷一下，还是看着这个无聊感然后继续听？这就是自我管理。</p><p>王阳明后来在赣南剿匪、平定宁王之乱的过程中用兵如神。有人问他用兵之道，他说：”<strong>此心不动，随机而动——如果非要说有技巧，那此心不动就是唯一的技巧。</strong>“战场就是最大的”事”——瞬息万变，压力极大，任何一个人的念头都可能在那一刻被恐惧、贪婪、愤怒带着跑。而他的应对是：不让心被任何东西粘住。不管外部多乱，此心不动。然后基于当下最清晰的信息做出反应。<strong>此心不动，随机而动。</strong> 这八个字，我觉得就是对”善护念”的最高操作化。</p><p>聊到这儿，你可能会觉得——这些都是古人的东西，凭经验摸索出来的，有没有现代科学的证据？</p><p>有，而且不少。而且很多研究的结论，往回看，和这三个古人说的几乎一模一样，只是换了一套语言。</p><p>沃尔特·米歇尔（Walter Mischel）在 1960 年代末做的那个著名实验，你可能已经听过了：给小孩一个棉花糖，告诉他如果能等十五分钟不吃，就能拿到两个。但这个实验最容易被忽略的地方不是”能等的小孩后来更成功”这个相关性结论——而是<strong>那些能等的小孩，到底是怎么做到的。</strong></p><p>米歇尔发现，能等的孩子和不能等的孩子，差别不在于”意志力”的强弱，而在于他们使用了完全不同的<strong>注意力策略</strong>。有的孩子把眼睛蒙起来不看棉花糖，有的转过身去，有的把棉花糖想象成一片云或者一个棉球。一个小孩的解释特别经典——“你不能吃一幅画。”他把棉花糖在脑子里变成了一幅画，然后欲望就解除了。而那些失败的孩子呢？他们直勾勾地盯着棉花糖，脑子里全是它有多甜多软多好吃。他们把注意力全部集中在刺激物的”热”特征上——结果不出意外地失败了。</p><p>米歇尔和梅特卡夫（Metcalfe &amp; Mischel, 1999）由此提出了<strong>热系统&#x2F;冷系统模型</strong>。热系统是情绪性的、简单的、反射性的，以杏仁核为中心，关注的是”这个好好吃””我现在就要”。冷系统是认知性的、复杂的、反思性的，以前额叶和海马体为中心，关注的是”这是白色的、圆的、像棉花一样的东西”。<strong>让一个小孩从”等不了”变成”等得了”，不需要改变他的性格，只需要教他把注意力从热特征转向冷特征。</strong> 默里等人（Murray et al., 2016）后来做了干预实验，用注意力训练技术（ATT）训练儿童，结果儿童的延迟等待时长提升了 2.64 倍。</p><p>米歇尔自己说了一句我觉得至关重要的话——“如果你不知道如何延迟满足，你就没有选择。如果你知道，你就有选择。”<strong>善护念练的就是这个”知道如何”。</strong> 曾国藩盯着自己的日记而不是盯着外界诱惑，富兰克林盯着自己的功过格而不是盯着即时快感，王阳明盯着心体不动而不是盯着情绪起伏——他们在做的事情，本质上和那些蒙上眼睛不看棉花糖的孩子是同一种操作：<strong>把注意力从”热系统”的目标上移开，让它冷却下来，让前额叶有时间介入。</strong></p><p>而这里面一个很大的反常识是：”知道”并不难，”做到”才难。而且这个难，随着时代变化正在指数级上升。</p><p>我们通常以为多巴胺是快乐物质。错了。罗宾逊和贝里奇（Robinson &amp; Berridge, 1993）用一系列实验证明了：多巴胺中介的不是”喜欢”（liking），而是”想要”（wanting）。<strong>快乐是另一套系统管的，和内啡肽、血清素有关。多巴胺管的是驱动力——你愿不愿意动起来去追求某个东西。</strong> 这个区分解释了太多事情。你刷短视频，刷到的内容一半以上你根本不觉得好看，但你的手指还在滑。为什么？因为多巴胺不是让你享受当前这一个视频，而是让你期待<strong>下一条</strong>可能是好的。它卖的不是”已获得”，是”可能获得”。</p><p>行为心理学里有一个经典机制叫变比率强化（variable-ratio reinforcement）：奖励随机出现时，行为最难以消退。斯金纳（B.F. Skinner）在 1950 年代就证明了鸽子在随机奖励条件下啄键的频率和持久性远高于固定奖励条件。老虎机是这个原理——你永远不知道下一次拉杆会不会中奖，所以你一直拉。而短视频的推荐算法，本质上就是把这个机制塞进了每个人的口袋。你不知道下一条会不会是爆款，所以你的大脑持续分泌”想要”的多巴胺，你的手指持续滑动。</p><p>当你习惯了这种<strong>每分钟十几次随机奖励</strong>的节奏之后，翻开一本需要连续投入三十分钟的书，你的大脑会怎么反应？它会觉得这本书有毛病。一页纸看到底了，没有奖励弹出来。十页看完了一个章节，没有反馈信号。书不给即时的、高频的、不确定的正反馈。你的多巴胺系统已经被校准到了一个书无法满足的阈值。然后你觉得无聊。<strong>无聊不是书的问题。无聊是多巴胺阈值被人为拉高之后，你对正常回报率的厌恶。</strong></p><p>最新的神经科学研究进一步确认了这一点。2025 年发表在 <em>Journal of Integrative Neuroscience</em> 上的一项研究（Zhang et al., 2025）发现了直接的行为学证据——<strong>自发眨眼频率（EBR）越高的人，走神频率也越高。</strong> 眨眼频率是中枢多巴胺水平的一个可靠代理指标。换句话说，多巴胺水平越高，注意力越不稳。因为多巴胺的功能不是帮你盯住目标，而是帮你<strong>切换</strong>目标。它在你的注意力系统里扮演的角色是方向盘，不是发动机。把你的自我管理理解成一个开车的过程：<strong>多巴胺决定你的方向盘往哪打，前额叶决定你能不能踩住刹车不被打偏。</strong> 如果你的多巴胺系统已经被短视频训练得每隔几秒就想打一把方向，那前额叶再强也扛不住。</p><p>还有一个维度要聊——意志力本身。</p><p>罗伊·鲍迈斯特（Baumeister et al., 1998）当年做了一个著名的实验：让一组人抵抗新鲜出炉的巧克力曲奇的诱惑，只能吃萝卜，然后让他们解一道无解的几何题。结果吃了萝卜的人比控制组放弃得快得多。鲍迈斯特因此提出了**”自我损耗”（ego depletion）**模型——意志力像肌肉，用了就会疲劳。这个理论在当时影响巨大，但后来出了问题。2016 年，一项包含 23 个实验室的大规模预注册重复研究（Hagger &amp; Chatzisarantis, 2016）发现——自我损耗效应的平均值趋近于零（d &#x3D; 0.04）。卡特和麦卡洛（Carter &amp; McCullough, 2015）的元分析也发现了发表偏差的痕迹，校正后效应量缩水到不显著。</p><p>但更有意思的是后续发现。乔布、德韦克和沃尔顿（Job, Dweck &amp; Walton, 2010）发现：<strong>相不相信意志力是有限的，决定了你是否会出现自我损耗。</strong> 如果你真心认为意志力是无限的，你的表现就不会下降。一个真正的生理资源不该因为”你不信”就不耗尽。这让资源耗竭模型很难自圆其说。因兹利希特和施梅歇尔（Inzlicht &amp; Schmeichel, 2012）提出的替代理论认为：自我损耗不是一个油箱在漏油，而是你的<strong>动机和注意力从”我应该做”转向了”我想要做”</strong>。你的前额叶并没有”用光”，它只是把资金调到了另一个账户上。</p><p>这个解释框架几乎完美地回到了王阳明——“此心不动，随机而动”不是靠能量多，是靠不被错误的动机牵引。</p><p>写到这儿，可以把线收拢了。</p><p>人类历史上最会自我管理的三个人——曾国藩、富兰克林、王阳明——用了不同的语言、不同的系统、不同的操作界面，在互相完全不知情的情况下，得出了同一个底层公式：<strong>自我管理 ≠ 时间管理 ≠ 意志力硬扛。自我管理 &#x3D; 管住你的念头往哪走。</strong></p><p>曾国藩用日记把念头放到放大镜下审视，富兰克林用功过格每晚做一次念头审计，王阳明做到极致——在任何事情发生的当下，念头不被打偏。他们用的是不同的”护念”技术，但护的都是同一件事：注意力资源的分配方向。</p><p>现代的棉花糖实验告诉你：延迟满足不是靠意志力强度，是靠你能不能把注意力从”热”刺激上移开。多巴胺研究告诉你：你的”想要”比你的”喜欢”更强大，而且这个系统已经被现代数字环境训练得过度敏感。自我损耗的修正研究告诉你：如果你认为你的注意力是无限的，它就真的更不容易枯竭。</p><p>所有这些，归结到操作层面，就是南怀瑾从《金刚经》里提取出来的那三个字——<strong>善护念。</strong></p><p>你不需要每天列八条待办事项然后完成两条。你不需要在手机上装三个屏幕时间管理软件然后每次都点忽略。你需要的是一件事：<strong>在你伸手去拿手机的前 0.5 秒，看见那个”我想刷一下”的念头。</strong> 不是消灭它。是看见它。然后选择不跟它走。</p><p>曾国藩花了三十年练这件事。富兰克林花了一辈子。王阳明说”持志如心痛”——如果你的志向是真的，你不可能被一条推送提醒打断，就像你不可能因为路过一家便利店就忘了自己的心脏在痛。</p><p>我们能做的大概比他们差得多。也许十分之一，也许百分之一。但方向是一样的——在你的念头起落的那些缝隙里，抢回一点点决定权。</p><p>和这三个人的功夫比起来，我们今天面临的环境其实比他们更恶劣。他们没有短视频，没有推荐算法，没有口袋里的老虎机。但他们依然花了三十年来管念头。我们面对的刺激强度是他们的百倍，却指望靠一个番茄钟 App 解决问题——这不现实。但也不需要那么极端。护念不是完全的念头隔绝，不是从此不看手机、不刷视频、不娱乐。那既不现实也没必要。护念是——刷完一条，在手指滑向下一条之前的那半秒，你能看见”我又想再刷一条了”，然后你可以选择”再刷一条”或者”放下了，回到要做的事情上”。</p><p>重点不是赢每一场。重点是你能看见战场在哪。</p><p>富兰克林在小册子上画黑点的那一刻，曾国藩在烛光下把自己骂到狗血淋头的那一刻，王阳明在战场中心说”此心不动”的那一刻——他们都在做同一件事：当念头冒出来的时候，他们看见了它，然后不给它自动驾驶权。</p><p>这就是自我管理的全部秘密。没有什么更高级的东西了。三个活在不同时代、不同文化里、从不知道彼此存在的顶尖自我管理者，推出来的都是这个公式。</p><p>“云何应住，云何降伏其心？”</p><p>住了三十年，还在住。这就是答案。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2026/05/16/%E5%96%84%E6%8A%A4%E5%BF%B5%EF%BC%9A%E8%87%AA%E6%88%91%E7%AE%A1%E7%90%86%EF%BC%8C%E7%AE%A1%E7%9A%84%E6%98%AF%E5%BF%B5%E5%A4%B4/</id>
    <link href="https://maybejustlikethis.github.io/2026/05/16/%E5%96%84%E6%8A%A4%E5%BF%B5%EF%BC%9A%E8%87%AA%E6%88%91%E7%AE%A1%E7%90%86%EF%BC%8C%E7%AE%A1%E7%9A%84%E6%98%AF%E5%BF%B5%E5%A4%B4/"/>
    <published>2026-05-16T06:00:00.000Z</published>
    <summary>从金刚经&quot;善护念&quot;聊起，借曾国藩、富兰克林、王阳明三个人的自我管理系统，以及棉花糖实验和多巴胺研究，聊聊自我管理真正的对象不是时间也不是行为，而是念头。</summary>
    <title>善护念：自我管理，管的是念头</title>
    <updated>2026-05-31T06:31:41.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/categories/%E6%9D%82%E8%B0%88/"/>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/tags/%E6%9D%82%E8%B0%88/"/>
    <content>
      <![CDATA[<h1 id="标签：互联网时代的一维化解法"><a href="#标签：互联网时代的一维化解法" class="headerlink" title="标签：互联网时代的一维化解法"></a>标签：互联网时代的一维化解法</h1><blockquote><p>“你对我的解读，构不成万分之一的我，而构成了一览无余的你。”</p></blockquote><p>小学的时候，有一次机会去同学家做客。这个同学的成绩在我们班排倒数第一，平时你在教室里看他，标签很清楚——“差生”，不爱学习，上课走神，考试垫底。到此为止了，这个标签已经足够让大多数人停止继续观察他。</p><p>但那天去到他家里，我看到的是另一个人。</p><p>他爸做饭特别厉害，厨房里忙活了一下午，端出来满满一桌子菜，每一道都很用心。他爸妈对他说话的语气很温和，家里的气氛是暖的。他很机灵——打游戏反应极快，操作比我们所有人都溜。他脾气好，被开玩笑也不急眼，笑呵呵的。他在自己家里是松弛的、立体的、闪闪发光的人。</p><p>我那时候还小，说不出什么大道理，但心里种下了一个印象：<strong>原来”差生”这个标签，只能覆盖他众多切面里最不重要的一角。</strong> 而他在教室里被定义的那个版本，甚至不是真实的他——那是他被塞进一个狭窄标签之后，不得不扮演的角色。</p><p>这件事后来成了我心里一个锚。每当我想快速判断一个人的时候，它会把我的判断往回拉一拉。</p><hr><h2 id="标签的本质不是分类，而是停止观察"><a href="#标签的本质不是分类，而是停止观察" class="headerlink" title="标签的本质不是分类，而是停止观察"></a>标签的本质不是分类，而是停止观察</h2><p>互联网把标签变成了一种通用语言。你去任何一个社交平台，评论区、个人简介、话题广场里，到处都挂满了标签：INTJ、天蝎座、XX主义者、i人、e人、钝感力、讨好型人格、原生家庭受害者……</p><p>标签最初的功能是索引。它帮你快速定位一个人大概是什么样的——就像图书馆里的分类编号。但问题是，图书馆里的书不会因为你给它贴了”哲学”的标，就真的只有哲学那一面。而人会。</p><p>当标签从一个临时的、可修改的描述，变成了一个固定的、不容置疑的身份，它就坏掉了。</p><p>我观察到一个很有意思的现象：标签越是不精确，人们反而抓得越紧。MBTI 在心理学界从来没有被当成严谨的分类工具——它的发明者 Katharine Cook Briggs 和 Isabel Briggs Myers 都不是心理学家，测试本身的重测信度也很低，你隔两周再测一次大概率会变一个类型。但这不妨碍它成为互联网上最流行的社交货币。</p><p>因为精确的分类需要认知成本，而粗糙的标签足够好用。</p><p>“你是 INFP，所以你会这样”——这句话说出来，说话的人就不用再去理解对面那个具体的人了。不用去了解他的成长经历、他的矛盾、他不同于任何同类标签拥有者的独特之处。标签把这些都省略了。</p><p>某种意义上，标签是懒惰的产物。它把”理解一个人”这个高成本行为，替换成了”归类一个人”这个低成本行为。而互联网的节奏天然鼓励低成本——你哪有时间去真正了解每个网友是什么人？刷过去，贴个标，下一个。</p><hr><h2 id="标签作为武器，也作为盾牌"><a href="#标签作为武器，也作为盾牌" class="headerlink" title="标签作为武器，也作为盾牌"></a>标签作为武器，也作为盾牌</h2><p>更让人难过的是，很多人不只是给别人贴标签，还主动给自己贴标签。</p><p>这当然是好理解的。在一个所有人都用标签说话的环境里，你不给自己贴标签，就等于放弃了让别人快速认识你的渠道。你需要一个 MBTI 写在简介里，需要一个立场挂在嘴边，需要一套固定的说辞来解释自己——因为没人有耐心听你说完”我是一个什么样的人”。</p><p>但问题在于，标签一旦贴上，它就不再只是对外展示的东西了——它会反过来规定你。</p><p>我见过很多这种例子：一个人测出自己是 INFP，然后开始用 INFP 来解释自己所有的行为。”我社恐，因为我是 INFP。””我拖延，因为我是 INFP。””我敏感，因为我是 INFP。” 这些本来可以被改变的习惯，一旦找到了标签做靠山，就变得名正言顺了。</p><p>标签从描述变成了预言。它不再是”我从过去的经验中总结出自己是这样的”，而是”因为这个标签说我是这样的，所以我就这样了。”</p><p>这就是自我标签化最悲哀的地方：它看起来像自我认知，实际上是自我限制。你主动走进一个框里，然后把框的边界当成自己的边界。某种意义上，这不是认识自己，这是给自己画地为牢。</p><hr><h2 id="每个人都是不可压缩的"><a href="#每个人都是不可压缩的" class="headerlink" title="每个人都是不可压缩的"></a>每个人都是不可压缩的</h2><p>我们每个人在成长过程中有过无数个瞬间。每一次学习一个新东西、每一次在实践中碰壁然后站起来、每一次在深夜反复想一件事想到天亮……这些东西积累成了一个完整的人。一个能笑也能沉默、能坚定也能动摇、偶尔矛盾却并不分裂的、立体的、活生生的人。</p><p>但标签不关心这些。标签把你一维化——把所有这些瞬间组成的厚度，打平成一个词，然后告诉你：”你就长这样。”</p><p>互联网放大了这个效应。因为互联网的交流不是面对面的，你看不到对方的表情、语气、犹豫、微妙的情绪变化。你只能看到文字和标签。文字和标签本身就已经是简化之后的信息了，它们天然就容易把人二维化。而算法又进一步加持了这个趋势——越极端的标签越容易获得传播，越简单的归类越容易被平台推荐。</p><p>所以你看网上的争论，不管是关于性别、政治、生活方式还是价值观，最后都变成了两拨人互相甩标签。没有人真的在讨论问题，大家只是在给自己的标签体系寻找新的弹药。</p><p>我觉得这很可惜。</p><p>因为标签本可以是个好东西。它本可以是一个索引——一个临时的、可随时更新的、供你参考但不是用来下定论的工具。但一旦它变成了身份的替代品，变成了攻击别人的武器和原谅自己的借口，它就失去了这个功能。</p><hr><p>回到开头那句话：”你对我的解读，构不成万分之一的我，而构成了一览无余的你。”</p><p>一个人给另一个人贴标签的速度、方式、倾向，暴露的不是被贴标签的人长什么样，而是贴标签的人自己——他的思维习惯、他的安全感来源、他对复杂世界的耐受度。</p><p>急着把人分类的人，往往自己最害怕混乱。</p><p>而愿意花时间去理解一个具体的人的那些人，他们不需要标签。因为他们知道，每个人都是一本太厚的书，标题只是封面上的几个字而已。真正重要的内容，从来都在里面。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2026/05/11/%E6%A0%87%E7%AD%BE%EF%BC%9A%E4%BA%92%E8%81%94%E7%BD%91%E6%97%B6%E4%BB%A3%E7%9A%84%E4%B8%80%E7%BB%B4%E5%8C%96%E8%A7%A3%E6%B3%95/</id>
    <link href="https://maybejustlikethis.github.io/2026/05/11/%E6%A0%87%E7%AD%BE%EF%BC%9A%E4%BA%92%E8%81%94%E7%BD%91%E6%97%B6%E4%BB%A3%E7%9A%84%E4%B8%80%E7%BB%B4%E5%8C%96%E8%A7%A3%E6%B3%95/"/>
    <published>2026-05-11T06:00:00.000Z</published>
    <summary>标签化的本质不是分类，而是停止观察。从童年拜访&quot;倒数第一&quot;同学的故事出发，聊聊互联网如何把人压缩成一维符号，以及自我标签化是如何变成一种画地为牢的。</summary>
    <title>标签：互联网时代的一维化解法</title>
    <updated>2026-05-31T06:31:41.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/categories/%E6%9D%82%E8%B0%88/"/>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/tags/%E6%9D%82%E8%B0%88/"/>
    <content>
      <![CDATA[<h1 id="直觉：身体知道的，比大脑多"><a href="#直觉：身体知道的，比大脑多" class="headerlink" title="直觉：身体知道的，比大脑多"></a>直觉：身体知道的，比大脑多</h1><blockquote><p>“我们知道的多于我们能言说的。” —— 迈克尔·波兰尼</p></blockquote><p>写代码的时候，有时候你会有一种奇怪的感觉：说不上来为什么，但你就是觉得<strong>这段代码会出问题</strong>。不是 bug 已经冒出来了，而是在它还没发作的时候，身体先告诉了你——“这块不对”。</p><p>你会停下来，重新读几遍。有时候当场找到问题，有时候隔几天真的在那附近爆了个雷。而另一种情况是，代码写完了，跑得好好的，但你总觉得某个地方”写得不够好”，有一种隐隐的不安或者别扭。回头看，往往是那个地方的抽象不对、命名不顺、或者埋了一个未来会咬你的坑。</p><p>这种事情经历多了，你开始信任这种感觉。你不会给它起名字，只在心里觉得”嗯，我好像对代码有一点感觉了。”</p><p>另一种场景是选 offer。你画了一整张表格，薪资、成长空间、团队氛围、通勤距离、公司规模……逐个打分，加权求和。表格告诉你选 A，但你就是不想选 A。你对 B 有一种说不上来的偏向——可能 B 钱少一点，平台小一点，但你在 B 的面试里聊得更舒服，或者 B 做的事情让你觉得**”更有意思”**。表格是公平的，但你心里不服表格。</p><p>如果表格和内心的偏向指向同一个方向，你就是笃定的、流畅的、不需要纠结的。</p><p>纠结的时候，往往是<strong>表格说选 A，心里却说选 B</strong>。理性列了一长串证据，但直觉不给证据，只给一个结论。</p><p>这时候你会发现一个很有意思的事：直觉在说话的时候，从来不会给你一张 pros&#x2F;cons 清单。它不会解释自己。它只说”我觉得是这个”。</p><p>那你会问——凭什么？这个东西没有理由，凭什么信它？</p><p>我想聊的就是这个。</p><h2 id="你懂的，远比你”知道”的多"><a href="#你懂的，远比你”知道”的多" class="headerlink" title="你懂的，远比你”知道”的多"></a>你懂的，远比你”知道”的多</h2><p>迈克尔·波兰尼，一个匈牙利裔的哲学家和科学家，在 20 世纪中期提出过一个概念，叫**”默会知识”（Tacit Knowledge）**。</p><p><strong>我们知道的多于我们能言说的。</strong></p><p>他会举骑自行车的例子：你知道怎么骑，你不会倒，但你能不能用一堆公式和语言把”如何保持平衡”写下来，让另一个从来没骑过车的人看完之后直接上车就能骑？做不到。你的身体知道，但你的大脑说不出来。</p><p>类似的还有很多。</p><p>老医生走进病房，看了病人一眼就觉得不对，让他去查某项指标，果然异常。你跟他说”你是怎么看出来的”，他说”经验吧。”这不是谦虚，也不是敷衍。他是真的不知道该怎么用语言把这一眼里的信息量翻译给你。</p><p>老司机在前车还没有踩刹车灯的时候就开始减速，几秒钟后前车果然刹车了。他不知道前车要刹车，但他的身体知道——是前车姿态的某种微妙变化，是几十万公里驾驶在身体里留下了模式识别。<strong>他的身体比他的大脑更早看到了刹车。</strong></p><p><code>coding 的&quot;这块会出问题&quot;，就是默会知识。</code></p><p>你之前读过的好代码不是白读的。你踩过的坑不是白踩的。你看过的烂抽象、改过的烂命名、被某个设计决策反噬过的痛苦——这些都还在。它们不在你能随时调用的显性记忆里，但它们在你身体里，变成了一种更底层的东西：一种对代码”对不对”的<strong>嗅觉</strong>。</p><p>你不需要先列出十条标准再逐条检查，你的身体直接跳过了检查步骤，给了你一个心慌、别扭、或者一种说不清的笃定。这就是默会知识在工作。</p><p>波兰尼自己说得很直白：<strong>“默会知识不是显性知识的低级版本，相反，显性知识依赖于默会知识。”</strong> 你能把代码写好，不是因为你记住了 Clean Code 的全部原则，而是因为你的默会知识在帮你做绝大多数判断。原则只是出来善后的——帮你给已经形成的直觉找一个体面的解释。</p><h2 id="直觉就是”一下看到全部”的能力"><a href="#直觉就是”一下看到全部”的能力" class="headerlink" title="直觉就是”一下看到全部”的能力"></a>直觉就是”一下看到全部”的能力</h2><p>到这里，波兰尼解释了直觉从哪里来。但他没有完全解释直觉为什么有时候<strong>比理性更准</strong>。直觉的”来源”是经验的压缩态，这说得通。但它的”质量”怎么解释？为什么在某些情况下，直觉的综合判断比理性分析的得分表还要靠谱？</p><p>柏格森——一个法国哲学家，被叫了很多年”生命哲学家”——他提供了一条很有意思的思路。</p><p>柏格森认为，理性——就是那种把东西切开、分类、打分、比较的方式——天生有一个局限：<strong>它只能处理语言能描述的东西。</strong> 而语言，本质上是通用的、抽象的。当我们用理性分析的时候，我们不是在理解”这件事本身”，而是在把它放进已有的概念格子里面。</p><p>一个 offer 好不好，理性会把它切成薪资、平台、成长、氛围……每个维度单独打分。但一个 offer 的真实体验，不是这些分加在一起的总和。</p><p><strong>整体的东西不等于碎片之和。</strong> 你最后去的那个公司，你每天感受到的不是”薪资 8 分 + 平台 7 分”，你感受的是一个完整的、混合在一起的生活。</p><p>柏格森说，要把握整体，你需要的不是分析，是直觉。直觉不是低配版理性，直觉是另一种认识方式——它不把东西切碎，而是试图直接”进入”那个东西的内部。</p><p>你在选 offer 的时候，直觉做的事情是什么？它没有逐一比较薪资和平台。它在一瞬间，把你关于**”我是什么样的人”、”我想过什么样的生活”、”这个团队给我的感觉”、”五年后的我会不会后悔”**等等所有这些维度，一次性综合了起来。它给了你一个整体的、说不清理由的偏好。</p><p><strong>理性的天花板是”可以言说”，直觉的天花板是”可以把握”。</strong> 也就是说，理性的上限是被语言囚禁的——有些东西，它就是说不出来。而直觉，可以触碰到那些你表达不了但确实存在的东西。</p><p>比如面试的时候，有的面试官你聊得很好，技术问题都答上来了，对方评价也不错，但你就是觉得<strong>这家公司不太对</strong>。你说不出来是哪儿不对。是对方某个表情？是办公室空气里的什么东西？是某个回答里藏着一丝微妙的不一致？你不知道。但你感觉到了。</p><p>事后你可能发现，那个公司的 leader 风格和你合不来，或者那个团队的文化有点压抑。总之你的直觉抓到了一些东西，<strong>那些东西真实存在，但不在你理性分析的范畴里。</strong></p><h2 id="纠结是一种哲学"><a href="#纠结是一种哲学" class="headerlink" title="纠结是一种哲学"></a>纠结是一种哲学</h2><p>如果直觉这么牛，为什么我们还会纠结？</p><p>回到选 offer 的场景。如果不纠结，说明直觉和理性在同一个方向上——<strong>你想要的和”应该”要的重合了。</strong> 这很幸福，但不太常见。</p><p>大多数让人成长的决策，都在纠结区里。</p><p>纠结不是简单的”信息不足”或者”算不过来”。从更深的层面看，纠结是<strong>两种认识方式的冲突</strong>。理性数的是外部标准：薪资多少、平台多大、title 好不好听。直觉数的是内部标准：这个事情有没有意思、这个团队待着舒不舒服、这个方向是不是我真正想做的。</p><p>外部标准没有什么错。人活在现实里，要吃饭要租房要算数字。</p><p>内部标准也没有什么错。这些就是你真正在乎的东西——它们真实存在，即使你写不进简历。</p><p>波兰尼和柏格森合在一起，看纠结会更清晰一点：</p><p><del>直觉是超能力，可以替代理性。</del></p><p><strong>直觉只是另一种认识方式——它看到的东西更多，但打不出证据。</strong></p><ul><li>你的直觉来自于长期的默会知识积累——你在生活里一次又一次地感受到”什么是适合我的”、”什么让我舒服”、”什么让我痛苦”。这些东西积累下来，形成了一套你自己都不完全了解的判断系统。（<strong>波兰尼</strong>）</li><li>你的直觉可以”一下看到整体”，它同时考虑了外部条件、内部偏好、潜在感受、未来可能性……但不给你列明细。（<strong>柏格森</strong>）</li><li>而你的理性，只能处理能被语言描述的部分——也就是表格上的那些项目。薪资可以量化，成长空间可以打分，但”我在这个团队会不会真正开心”这种东西，你没法赋值，只能感觉。</li><li>于是两种认识方式产生了冲突——直觉说**”你应该选这个”<strong>，理性说</strong>“我没有选这个的数据支撑”**。</li></ul><p><strong>直觉打不出证据，但直觉看到了更多东西。</strong></p><p>纠结就是这张表格和这种感觉在谈判。</p><p>纠结不是坏事。你在纠结的时候，不是在浪费时间——你在试图让两种认识方式彼此倾听。你在努力把你的默会知识和你的理性判断对齐。这个过程本身，就是<strong>你对自己认真负责的模样。</strong></p><h2 id="信直觉，但别神化它"><a href="#信直觉，但别神化它" class="headerlink" title="信直觉，但别神化它"></a>信直觉，但别神化它</h2><p>聊到这儿，我总觉得得拉回来一点。要不然容易把直觉写成某种超能力。</p><p><strong>直觉不是完美的。它有天花板。</strong> 这个天花板不是柏格森说的理性的天花板，而是<strong>经验的边界</strong>——你的直觉只在你深耕过的领域里靠谱。</p><p>一个老医生看病人有直觉，但让他去修车，他的直觉就是噪音而不是信号。一个老司机开车有直觉，但让他去写代码，他的”感觉”跟随机猜没什么区别。</p><p><strong>直觉的可靠性，和你在这个领域里积累的默会知识的厚度成正比。</strong></p><p>所以有一个很简单的原则：<strong>在深耕的领域，相信直觉；在陌生的领域，直觉只是偏见。</strong></p><p>在你自己写了五六年代码之后，”这块好像会出问题”是值得认真的信号。在你开了十年车之后，下意识想要踩刹车是值得信任的。在你认真过自己的生活很多年以后，那种”我好像真的想要这个”的感觉，是有分量的。</p><p>但在完全陌生的领域——你第一次炒股、第一次装修、第一次和某个类型的人打交道——那种”我觉得”大概率只是刻板印象或者情绪反射，和直觉没有关系。<strong>这不是直觉，这是错觉。</strong></p><p>分辨这两者，本身就是一种默会知识：你越认识自己，你越知道自己哪些感觉靠谱，哪些不靠谱。</p><h2 id="最后"><a href="#最后" class="headerlink" title="最后"></a>最后</h2><p>直觉终归不是什么神秘的东西。它是我们经验的压缩态，是身体替我们记住了太多大脑说不出来的事情。</p><p>学会辨认它——什么时候它在说话，什么时候它在误报。<br>学会尊重它——在你深耕的领域里，它往往比你的理性看到得更多。<br>学会审视它——认出它的边界，知道它在什么地方不可信。</p><p>我想这大概是一个成年人能对自己做出的最好的信任——不是相信直觉永远对，而是相信直觉值得被倾听。毕竟，那里面装着你在世界上活过的所有年岁。你的身体比你的简历长了更多记性。它能告诉你的，远比一份表格要多。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2026/05/10/%E7%9B%B4%E8%A7%89%EF%BC%9A%E8%BA%AB%E4%BD%93%E7%9F%A5%E9%81%93%E7%9A%84%EF%BC%8C%E6%AF%94%E5%A4%A7%E8%84%91%E5%A4%9A/</id>
    <link href="https://maybejustlikethis.github.io/2026/05/10/%E7%9B%B4%E8%A7%89%EF%BC%9A%E8%BA%AB%E4%BD%93%E7%9F%A5%E9%81%93%E7%9A%84%EF%BC%8C%E6%AF%94%E5%A4%A7%E8%84%91%E5%A4%9A/"/>
    <published>2026-05-10T06:00:00.000Z</published>
    <summary>直觉不是玄学——它是经验的压缩态，是身体替我们记住了太多大脑无法言说的东西。从波兰尼的默会知识到柏格森的直觉主义，聊聊直觉从哪里来、为什么靠谱、以及什么时候该信它。</summary>
    <title>直觉：身体知道的，比大脑多</title>
    <updated>2026-05-10T05:31:15.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/categories/%E6%9D%82%E8%B0%88/"/>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/tags/%E6%9D%82%E8%B0%88/"/>
    <content>
      <![CDATA[<h1 id="从《搏击俱乐部》聊起"><a href="#从《搏击俱乐部》聊起" class="headerlink" title="从《搏击俱乐部》聊起"></a>从《搏击俱乐部》聊起</h1><blockquote><p>“你拥有的东西最终会拥有你。” ——《搏击俱乐部》</p></blockquote><p>最近又把《搏击俱乐部》翻出来看了一遍，说实在的，第一次看的时候关注的都是那些很刺激的场面，打斗啊，反转啊，Tyler Durden有多酷啊之类的，但是这次重看，反倒被一些很安静的镜头击中了。</p><p>有一个场景是主角站在自己被炸掉的公寓废墟前，那些他一本一本从宜家目录上精心挑选的家具，那些构成了他”体面生活”的一切，全没了。但是他的表情不是崩溃，反倒有一种说不上来的……轻松？</p><p>我当时就愣了一下，因为这种感觉其实挺熟悉的。</p><p>你有没有过那种时刻，打开手机准备买点什么，但突然意识到自己其实根本不需要它，只是最近有点焦虑，或者有点无聊，或者刷到了某个帖子让你觉得”好像我也该有这个东西”？我就经常这样，每次收到快递拆开那一瞬间是开心的，但这种开心大概维持不了半天，然后东西就放在那里，慢慢变成生活背景的一部分，你也分不清它到底是丰富了你的生活，还是只是占了一个位置。</p><p>《搏击俱乐部》里其实一直在讲这个事。主角的公寓像一本被复制出来的生活方式杂志，每一件东西都”对”，都在告诉别人”我是一个有品味的人”，但他自己却失眠、空虚，每天机械地上班下班，精神状态几乎是在梦游。他拥有了一切该拥有的东西，但好像什么也没抓住。</p><p>我觉得消费主义最厉害的地方就在这里，它从来不只是卖你一个商品，它卖的是一种想象。</p><p>你买的不是那件衣服，是”穿上它之后的我”；你买的不是那台设备，是”拥有它之后更高效的自己”；你买的不是那张健身卡，是”坚持下去之后更好看的身体”。它永远在卖一个还没发生的、更好的你，而你永远在为这个幻觉付费。</p><p>而且这件事最狡猾的地方在于，它不会让你觉得被控制了，反而让你觉得是自己在做选择。”我买是因为我喜欢”，”我买是因为我值得”，听起来很对，也很舒服，但是仔细想想，这个”喜欢”和”值得”的标准，真的是你自己定的吗？</p><p>很多时候我觉得，我们对”好生活”的想象，大部分都不是自己从零开始构建的，而是被各种信息源一点点塑造出来的。哪些品牌是高级的，什么样的穿搭是体面的，什么样的生活方式是值得羡慕的，这些东西在你还没来得及思考之前，就已经被写进了你的判断体系里。</p><p>所以你每次消费，看起来是在满足自己的需求，但更深一层，可能只是在回应一个早就被植入的暗示：你还不够好，你还需要这个。</p><p>而且这个暗示永远不会消失。因为消费主义不是卖你一次东西就结束了，它需要你持续地不满足。护肤品解决完这一季的焦虑，下一季就会告诉你还有新的问题需要处理；刚换完手机，半年后就开始有声音告诉你新出了更好的；家里的东西明明够用，但总有新的风格新的概念新的必需品冒出来，让你觉得现在这些好像已经”过时”了。</p><p>说到底它贩卖的不是商品，是焦虑。先把焦虑种下去，再告诉你买什么能缓解它，然后确保这个缓解是暂时的，这样你就会一直回来。</p><p>其实 Tyler Durden 在电影里说的那句”你拥有的东西最终会拥有你”，我一直觉得挺对。不是说不让人买东西，人当然需要消费，吃饭穿衣住房这些都是正常生活，不可能也不应该否定。但是当你开始用拥有的东西来定义自己是谁的时候，事情就慢慢变味了。</p><p>你用什么手机决定你是否先进，穿什么牌子决定你是否体面，住什么房子决定你是否成功，去哪里旅行决定你是否热爱生活。当所有这些外部标签构成了一个人的全部，那个人本身就越来越空了。不是物质的空，而是精神上那种，你很难说清楚自己到底喜欢什么，因为你以为的喜欢，可能只是被培养出来的习惯。</p><p>写到这我突然想到一个问题：如果有一天，没有任何人看见你用的东西、穿的衣服、住的房子，你还会买它们吗？</p><p>这个问题其实挺残忍的。因为认真想下去你会发现，有些东西可能真的不是买给自己的，是买给那个”被别人看到的自己”的。而那些真正让自己开心的、安静的、不需要任何人确认的小事情，往往反而花不了多少钱。比如一个好天气，比如深夜安安静静看一部好电影，比如突然想明白了一个困扰自己很久的问题，这些时刻是真实的，但它们没法被装进购物车里。</p><p>我觉得《搏击俱乐部》最刺痛人的地方就在这里。它用一个很极端的故事提醒了一件事：当一个人把自我全部建立在外部物品上时，他看起来什么都有，但内里可能是空的。</p><p>但我也并不觉得 Tyler 的答案是正确的。他的问题在于，他反对消费社会的控制，但最后建立的是另一种更危险的控制。他反对商品塑造身份，于是用暴力塑造身份；他反对现代规训，于是建立了更极端的纪律。看起来是反叛，其实只是换了一个主人。</p><p>所以真正的反抗可能不是炸掉一切，而是在这个不断告诉你”你还不够好，所以你还需要买点什么”的世界里，试着保留一点自己的判断。</p><p>这其实很难，真的很难。因为你不是在一个真空环境里做选择，你周围的一切——广告、社交媒体、同龄人、评价体系——都在推着你往那个方向走。你能做的可能只是在每一次想要消费的瞬间，稍微停一下，问自己一句：我到底是真的需要，还是只是被什么触动了？</p><p>如果能诚实回答这个问题，我觉得就已经比大多数人多走了一步了。</p><p>毕竟生活终归还是自己的，不是买出来的。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2026/04/26/%E4%BB%8E%E3%80%8A%E6%90%8F%E5%87%BB%E4%BF%B1%E4%B9%90%E9%83%A8%E3%80%8B%E8%81%8A%E8%B5%B7/</id>
    <link href="https://maybejustlikethis.github.io/2026/04/26/%E4%BB%8E%E3%80%8A%E6%90%8F%E5%87%BB%E4%BF%B1%E4%B9%90%E9%83%A8%E3%80%8B%E8%81%8A%E8%B5%B7/"/>
    <published>2026-04-25T16:00:00.000Z</published>
    <summary>从《搏击俱乐部》聊聊反消费主义</summary>
    <title>从《搏击俱乐部》聊起</title>
    <updated>2026-05-31T06:31:41.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/categories/%E6%9D%82%E8%B0%88/"/>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/tags/%E6%9D%82%E8%B0%88/"/>
    <content>
      <![CDATA[<p>长久以来，我们都沉浸在”互联网实现了信息平权”的认知里——觉得只要有网络、有设备，人人都能搜到想要的信息，都能站在同等的信息起跑线上。可随着AI大模型时代到来，当技术抹平了表层的信息获取门槛，藏在水面之下的真实不平等，才渐渐浮出水面。我们如今谈论的信息平权，早已偏离了原本的核心，所谓的公平，不过是一层看似美好却不堪一击的外壳，真正的信息平权，在当下依旧遥不可及。</p><h2 id="一、信息平权的核心早已转移：从渠道平权，到数据源垄断"><a href="#一、信息平权的核心早已转移：从渠道平权，到数据源垄断" class="headerlink" title="一、信息平权的核心早已转移：从渠道平权，到数据源垄断"></a>一、信息平权的核心早已转移：从渠道平权，到数据源垄断</h2><p>前AI时代的信息平权，是停留在表面的渠道平权。互联网普及后，搜索引擎、各类平台打破了信息传播的地域与阶层限制，无论普通人还是企业，都能通过公开渠道浏览资讯、查找知识，不用再被信息渠道的壁垒阻隔，这是我们最初理解的信息平等，也是大众普遍认可的平权形态。</p><p>但进入后AI时代，这套逻辑彻底失效了。真正决定信息价值的，早已不是”能不能看到信息”，而是”能不能拿到高价值、真实有效的原始数据”，这便是数据源的不平等，也是当下最核心的信息壁垒。就像最典型的12306火车票数据，所有人都能通过官方渠道查票、购票，这是渠道上的平等；可从正规途径来看，普通个体、中小团队根本无法获取全量、实时的票务数据，爬虫获取属于违规行为，这类高价值公共数据，始终被牢牢掌握在少数主体手中。</p><p>诸如政务数据、行业交易数据、实时业务数据等有决策价值、能支撑深度分析的核心数据，大多处于封闭状态，普通人根本没有合规获取的途径。前AI时代我们争的是”看得到”，后AI时代我们连”碰得到”核心数据的权利都没有，数据源的垄断，才是信息平权最根本的障碍。</p><h2 id="二、数据真实性是底线：无真实，不平米"><a href="#二、数据真实性是底线：无真实，不平米" class="headerlink" title="二、数据真实性是底线：无真实，不平米"></a>二、数据真实性是底线：无真实，不平米</h2><p>当我们讨论数据平权时，除了能否获取核心数据，数据的真实性是绝不能忽视的底线，也是数据平权的核心前提。真正有含金量的数据，本就是极度稀缺的资源，而虚假数据的破坏力，远比我们想象中更强大。</p><p>这就像一堆口感纯正的糖里，混进了一颗带着老鼠屎味的糖，人们不需要尝完所有糖，只要吃到这一颗坏糖，就会对整盘糖产生彻底的怀疑，这就是数据造假带来的信任崩塌效应。在信息传播与AI应用中，一旦数据源里掺杂虚假、错误、注水的内容，哪怕只是极小的比例，用户一旦发现，就会全盘否定这个信息源、甚至整个AI体系的可信度。</p><p>如果数据本身是虚假的，即便实现了所谓的”获取平权”，也毫无意义。这种情况下的平等，不过是让所有人平等地被误导、被蒙蔽，完全背离了信息平权的初衷。只有保证数据的真实可信，数据的获取与使用才有价值，这是数据平权不可逾越的底线，也是我们必须坚守的核心原则。</p><h2 id="三、水下的博弈：数字护城河的双重标准，藏着最隐蔽的不公"><a href="#三、水下的博弈：数字护城河的双重标准，藏着最隐蔽的不公" class="headerlink" title="三、水下的博弈：数字护城河的双重标准，藏着最隐蔽的不公"></a>三、水下的博弈：数字护城河的双重标准，藏着最隐蔽的不公</h2><p>当下的数据与信息博弈，早已不在台面上展开，而是在我们看不见的水下悄然进行，核心是各大厂商、平台构建的数字护城河，以及这套护城河背后的极端双重标准，这也是后AI时代信息不平等的直接体现。</p><p>传统互联网时代，厂商的护城河是技术壁垒。开发一款成熟的应用、搭建一套完整的业务体系，需要深厚的技术积累、专业的团队支撑，想要复刻竞争对手的业务模式，难度极高，技术成了划分厂商竞争力的核心边界。但AI大模型的出现，彻底抹平了应用开发的门槛：如今想要做一款外卖、电商类应用，借助AI大模型快速生成代码、搭建逻辑，小团队也能在短时间内完成，就像淘宝闪购想要复刻美团的外卖平台，应用本身的开发毫无难度。</p><p>真正难以复刻的，是核心数据与线下生态，这也让厂商的数字护城河，从技术壁垒转向了数据+生态壁垒。美团的外卖应用容易复制，但它深耕多年搭建的庞大骑手运输链、成熟的运力调度体系、千万商家合作资源以及海量用户消费数据，是花钱买不来、时间追不上、AI替代不了的核心资产。</p><p>于是，各大厂商开始死守自己的数字护城河：对自身的核心业务数据、用户数据严防死守，不仅对普通人封闭，对竞争对手更是处处提防，生怕核心竞争力被撼动；可面对普通用户，他们却毫无底线地践踏数字边界。从早期借个性化推荐算法的噱头，隐蔽收集用户行为资料，到如今借助AI大模型，更全面、更系统、更隐蔽地全维度采集用户信息，这个过程越来越难以察觉，却实实在在地发生着。</p><p>大多数人在日常使用中，很难感知到这种博弈的存在，觉得不影响正常生活，可这种数据层面的垄断与掠夺，早已在底层构建起难以打破的数字不公：你的数据被随意采集，成为厂商护城河的一部分，而厂商的核心数据，你永远无法触及。</p><h2 id="结语"><a href="#结语" class="headerlink" title="结语"></a>结语</h2><p>后AI时代，我们必须打破对”信息平权”的固有认知。真正的信息平权，从来不是人人都能刷到同样的短视频、搜到同样的公开资讯，而是每个人都能平等地获取真实、有价值、可合规使用的核心数据，是数据的获取、使用与归属都能实现公平。</p><p>可当下的现实是，数据源被垄断、数据真实性难保障、厂商靠着双重标准构建数字特权，我们依旧活在表层平等、底层不公的信息环境里。这场藏在水下的数据博弈，终会影响每一个人，而正视这份不平等，或许是我们迈向真正信息平权的第一步。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2026/04/06/%E5%90%8EAI%E6%97%B6%E4%BB%A3%EF%BC%9A%E6%88%91%E4%BB%AC%E6%89%80%E4%BB%A5%E4%B8%BA%E7%9A%84%E4%BF%A1%E6%81%AF%E5%B9%B3%E6%9D%83%EF%BC%8C%E4%BB%8E%E6%9D%A5%E9%83%BD%E4%B8%8D%E6%98%AF%E7%9C%9F%E7%9A%84/</id>
    <link href="https://maybejustlikethis.github.io/2026/04/06/%E5%90%8EAI%E6%97%B6%E4%BB%A3%EF%BC%9A%E6%88%91%E4%BB%AC%E6%89%80%E4%BB%A5%E4%B8%BA%E7%9A%84%E4%BF%A1%E6%81%AF%E5%B9%B3%E6%9D%83%EF%BC%8C%E4%BB%8E%E6%9D%A5%E9%83%BD%E4%B8%8D%E6%98%AF%E7%9C%9F%E7%9A%84/"/>
    <published>2026-04-06T05:00:00.000Z</published>
    <summary>后AI时代，真正的信息平权，从来不是人人都能刷到同样的短视频、搜到同样的公开资讯，而是每个人都能平等地获取真实、有价值、可合规使用的核心数据。</summary>
    <title>后AI时代：我们所以为的信息平权，从来都不是真的</title>
    <updated>2026-04-06T09:56:39.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/categories/%E6%9D%82%E8%B0%88/"/>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/tags/%E6%9D%82%E8%B0%88/"/>
    <content>
      <![CDATA[<blockquote><p>“千年暗室，一灯即明。”</p></blockquote><p>1914-1918年，第一次世界大战爆发，但是我们在这个地方不去讨论战争本身的对与错， 我只想揭示第一次世界大战带来的经济变化，市场供需关系的变化。</p><p>在战争结束后，坦克机械技术向农用拖拉机的转移，这一转变直接推动了农业生产的机械化革命。拖拉机的出现，深深地影响了农民：机械化让少量农民即可耕种大片土地，传统的小农经济逐渐被大农场模式取代，<strong>土地兼并</strong>和<strong>规模化经营</strong>成为趋势，农业生产的专业化、商品化程度大幅提升（农产品不再仅满足自给自足，而是成为<strong>商品</strong>进入市场）。</p><p>但是一辆拖拉机的价格是极其昂贵的，一辆较好的福特森（Fordson）履带式拖拉机需要800-1000美金左右，这在当时相当于一个农民一年的收入，如果农民需要购买拖拉机，在当时银行会给你提供贷款服务，多数农民都会选择去贷款，毕竟在当时看来，一辆拖拉机能够顶替相当几十人的劳动力，带来的农作物产出肉眼可见，于是许多农民贷款购买了拖拉机。在购买后的一年到两年内，许多农民切实的靠拖拉机赚到了钱，但是三年四年，问题出现了：</p><p><strong>以原来的价格，粮食卖不出去了</strong>。</p><p>这是一个典型的供需关系的问题：农作物生产的提高，实际上是效率的提升，并不能带来需求，人们不会因为农作物产量高，就吃的多。反而因为农作物产量翻了十倍，导致了农作物价格的暴跌。最后农民们发现了一个结果：我和之前农耕的收入，几乎差不多，甚至还变低了。</p><p>这一方面淘汰了没有使用拖拉机的农户，另一方面，农业变成了一个需要成本控制的行当，随之带来的就是土地兼并和规模化经营，大量小农场被兼并……等等深远的影响。</p><p>聚焦于农户个体，我们更能发现问题：收入差不多的情况下，我被迫背上了债务。时间周期一拉长，我发现我还不起贷款。面临破产，土地被兼并，机器被贱卖。重新变成了穷光蛋，很长一段时间内，没有消费能力，而城市里的工厂在加大马力，日夜不停的生产工业品。</p><p>我们常说行为具有惯性，一个人的惯性或许不显，一群人的惯性就会成为越滚越大的雪球，难以停下，最终摧毁一切。</p><p><strong>时间跨度拉到10年后，1929年金融危机爆发。</strong></p><p>简单来说：1920 年代初的农业危机，是美国整体经济危机的 “先声”，这场持续近 10 年的农业萧条，逐步向工业、金融、消费领域传导，最终与股市泡沫、信贷过度、工业产能过剩等问题叠加，共同引爆了 1929 年的大崩盘，且让大萧条的影响更深远、复苏更艰难。</p><p>1920 年代初农民贷款购买拖拉机、土地形成的债务，成为美国银行业的第一批大规模坏账，暴露了金融体系的脆弱性：</p><ul><li><p>乡村银行率先爆发危机：1921-1929 年，美国有超 6000 家乡村银行倒闭（占当时银行总数的 1&#x2F;3），核心原因是农民贷款违约 —— 农民因农产品价格暴跌无力偿还农机、土地贷款，银行抵押的土地 &#x2F; 农机因市场萧条大幅贬值，最终资不抵债；</p></li><li><p>信贷扩张的 “前车之鉴” 未被重视：1920 年代初的农业信贷危机，本质是 <strong>“过度信贷支持产能扩张，最终因供需失衡导致违约”</strong>，但美国金融体系并未吸取教训，反而将这种信贷扩张模式复制到城市 ——1920 年代中后期，银行向城市居民提供大量消费信贷（买车、买家电）、股市保证金贷款，杠杆率远超农业信贷，最终成为 1929 年股市崩盘、银行倒闭的核心原因；</p></li><li><p>金融体系的区域传导：乡村银行倒闭后，资金向城市大银行集中，大银行将更多资金投入股市和工业信贷，进一步推高股市泡沫，形成 “农业坏账→城市资金空转→股市投机” 的恶性循环。</p></li></ul><p><strong>资产价格脱离实际价值，最终因供需失衡回归基本面</strong></p><p>所以 <strong>生产力高，尤其是带来的是效率的增加的时候，未必会带来需求的增加。</strong></p><p>需求增加无非绕不开几个事情：人口，经济的兴盛，群众的信心。</p><p>AI 似乎也是这样一回事。</p><p>AI，各大企业在不停的往里面投钱，不计代价的往里堆钱。如果堆完钱，悲切的发现：市场并不需要。会带来什么后果显然易见。但是AI有个特点：回到20世纪，内燃机替代了马车夫，多余的马车夫可以转行做司机，仅仅需要学车就可以做到，还可以去修车，还可以去维护车，还可以进厂当工人生产内燃机等等替代的岗位。但是AI完全不同，你的岗位被AI取代了，你去维修AI吗，还是维护AI？这种情况可能直到AGI（Artificial General Intelligence，人工通用智能）出现才会有缓解。各大公司通过AI降本增效之后，真的有更多的需求了吗？</p><p>题外话：<br>直到未来AGI出现前，AI应该会更加专项，我们面对这种情形，要掌握两个点：“跨”和“学”，跨领域的能力和学习的能力。越抽象的标签，越抽象的岗位越难被AI取代。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2026/01/28/%E4%BE%9B%E9%9C%80%E5%85%B3%E7%B3%BB%E4%B8%8EAI%E7%9A%84%E8%AE%A8%E8%AE%BA/</id>
    <link href="https://maybejustlikethis.github.io/2026/01/28/%E4%BE%9B%E9%9C%80%E5%85%B3%E7%B3%BB%E4%B8%8EAI%E7%9A%84%E8%AE%A8%E8%AE%BA/"/>
    <published>2026-01-28T13:39:50.000Z</published>
    <summary>供需关系与AI的讨论</summary>
    <title>供需关系与AI的讨论</title>
    <updated>2026-01-28T13:42:57.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="AI" scheme="https://maybejustlikethis.github.io/categories/AI/"/>
    <category term="AI" scheme="https://maybejustlikethis.github.io/tags/AI/"/>
    <content>
      <![CDATA[<h2 id="引言"><a href="#引言" class="headerlink" title="引言"></a>引言</h2><p>最近在开发一个学校项目的过程中，我高强度依赖了 Claude Code 进行编程辅助。这段经历给我带来了深刻的启示：虽然 AI 的编码速度惊人，但其生成的代码片段大多停留在 POC（Proof of Concept，概念验证）级别，距离生产环境或商业化的质量标准还有相当大的差距。</p><p>更令人警惕的是，如果缺乏有效的人工干预和质量控制，这些看似”可用”的代码在经历几轮迭代后，极易演变成难以维护的”技术债务”——也就是我们常说的”屎山代码”。这促使我深入思考：究竟如何才能在享受 AI 带来的效率提升的同时，确保代码质量不失控？</p><h2 id="为什么-AI-无法”一键生成”？"><a href="#为什么-AI-无法”一键生成”？" class="headerlink" title="为什么 AI 无法”一键生成”？"></a>为什么 AI 无法”一键生成”？</h2><p>这个问题成了我思考的起点。从纯粹的编码效率来看，AI 无疑是碾压级的存在——几乎没有程序员的打字速度能与 AI 的生成速度相提并论。然而，一个看似矛盾的现象摆在我们面前：为什么如此强大的 AI，却难以一次性输出高质量的、生产就绪的代码呢？</p><p>经过反复实践和深度思考，我识别出了几个关键的制约因素：</p><h3 id="❌-LLM-智力不足？"><a href="#❌-LLM-智力不足？" class="headerlink" title="❌ LLM 智力不足？"></a>❌ LLM 智力不足？</h3><p>这个原因基本可以排除。现在的顶级大模型在代码领域已经达到了中高级工程师的水平，无论是算法实现还是语法规范，都展现出了相当强的能力。</p><h3 id="🔴-上下文信息缺失"><a href="#🔴-上下文信息缺失" class="headerlink" title="🔴 上下文信息缺失"></a>🔴 上下文信息缺失</h3><p>这才是<strong>核心瓶颈</strong>所在。AI 缺乏对项目的全局认知，具体表现在：</p><ul><li>无法理解隐含的业务逻辑和领域知识</li><li>对项目的历史决策背景和演进路径一无所知</li><li>不清楚团队的编码规范和架构约定</li><li>难以感知代码库中已有的设计模式和最佳实践</li></ul><p>这些”隐性知识”恰恰是区分”能跑的代码”和”优秀的代码”的关键所在。</p><h3 id="🟡-上下文信息不精确"><a href="#🟡-上下文信息不精确" class="headerlink" title="🟡 上下文信息不精确"></a>🟡 上下文信息不精确</h3><p>当 AI 基于不精确或不完整的信息进行自主决策时，很容易产生一种特殊的错误——<strong>“智能错误”</strong>：代码看起来逻辑通顺、语法正确，但实际行为却与预期不符。这类错误往往比明显的 bug 更难排查，因为它们隐藏在看似合理的实现细节中。</p><h2 id="工程化解决方案"><a href="#工程化解决方案" class="headerlink" title="工程化解决方案"></a>工程化解决方案</h2><p>既然找到了问题的根源，接下来就是如何通过工程化手段来系统化地解决这些问题。根据目前业界的实践探索，我认为大致可以分为两条路径：</p><h3 id="路径一：迭代式开发"><a href="#路径一：迭代式开发" class="headerlink" title="路径一：迭代式开发"></a>路径一：迭代式开发</h3><p>引导 AI 进行多轮自我优化和迭代，通过不断的反馈循环提升代码质量。</p><p>在这个过程中，要求你<strong>一定要有一个持续性迭代的产品文档</strong>，不然需求的熵增会导致难以维护的后果。</p><h3 id="路径二：约束式开发"><a href="#路径二：约束式开发" class="headerlink" title="路径二：约束式开发"></a>路径二：约束式开发</h3><p>通过明确的规则和流程，让 AI 在可控的范围内执行任务，减少意外行为。</p><hr><h3 id="渐进式提示词工程"><a href="#渐进式提示词工程" class="headerlink" title="渐进式提示词工程"></a>渐进式提示词工程</h3><p>根据 Anthropic 官方的实践建议，可以通过 <strong>Skills</strong> 技术实现渐进式提示词（Progressive Prompting）。这种方法的核心思想非常直观：<strong>将复杂的任务拆解为多个简单步骤，每一步都有明确的输入和输出规范。</strong></p><h4 id="✨-核心优势"><a href="#✨-核心优势" class="headerlink" title="✨ 核心优势"></a>✨ 核心优势</h4><ul><li><strong>减少幻觉</strong>：大幅降低因单次提示词过长而产生的模型幻觉问题</li><li><strong>提升精度</strong>：提高每一步执行的精准度和可控性</li><li><strong>便于调试</strong>：当出现问题时，可以快速定位到具体的步骤</li><li><strong>模块复用</strong>：可以将验证过的提示词片段打包成模块，在不同项目中复用</li><li><strong>渐进增强</strong>：可以从简单版本开始，逐步增加复杂度，降低整体风险</li></ul><h4 id="💡-实践建议"><a href="#💡-实践建议" class="headerlink" title="💡 实践建议"></a>💡 实践建议</h4><p>在实际应用中，你可以这样设计渐进式提示词：</p><ol><li><strong>第一步</strong>：让 AI 理解需求和上下文（不要急于写代码）</li><li><strong>第二步</strong>：让 AI 设计整体架构和接口定义</li><li><strong>第三步</strong>：让 AI 实现具体功能模块</li><li><strong>第四步</strong>：让 AI 进行代码审查和优化建议</li><li><strong>第五步</strong>：让 AI 编写测试用例和文档</li></ol><p>每一步的输出都成为下一步的输入，形成一个良性的迭代循环。</p><hr><h3 id="工作流编排工具"><a href="#工作流编排工具" class="headerlink" title="工作流编排工具"></a>工作流编排工具</h3><p>除了渐进式提示词，业界还涌现了许多优秀的工作流编排工具，如 <strong>n8n</strong>、<strong>Dify</strong>、<strong>LangFlow</strong> 等。这些工具提供了可视化的编排界面，让开发者可以像”搭积木”一样构建复杂的 AI 应用。</p><h4 id="🎯-核心价值"><a href="#🎯-核心价值" class="headerlink" title="🎯 核心价值"></a>🎯 核心价值</h4><table><thead><tr><th>价值维度</th><th>具体表现</th></tr></thead><tbody><tr><td><strong>流程可视化</strong></td><td>将抽象的 AI 调用过程转化为直观的流程图，便于理解和沟通</td></tr><tr><td><strong>任务拆解</strong></td><td>将复杂需求拆解为多个原子化操作，每个操作职责单一</td></tr><tr><td><strong>精确控制</strong></td><td>每个步骤的输入输出都可以严格定义和验证，减少意外</td></tr><tr><td><strong>团队协作</strong></td><td>可视化的流程更容易在团队中分享、维护和传承</td></tr><tr><td><strong>版本管理</strong></td><td>可以对工作流进行版本控制，追踪每次变更的影响</td></tr></tbody></table><h4 id="🔧-选择建议"><a href="#🔧-选择建议" class="headerlink" title="🔧 选择建议"></a>🔧 选择建议</h4><ul><li><strong>n8n</strong>：适合需要集成多种第三方服务的场景，生态丰富</li><li><strong>Dify</strong>：专注于 LLM 应用开发，提供了很好的 prompt 管理能力</li><li><strong>LangFlow</strong>：如果项目基于 LangChain，这是一个自然的选择</li></ul><p>选择工具时，建议从团队的技术栈、学习成本和长期维护成本三个维度综合考虑。</p><h2 id="总结与展望"><a href="#总结与展望" class="headerlink" title="总结与展望"></a>总结与展望</h2><p>通过前面的分析，我们可以得出一个明确的结论：<strong>AI 辅助编程绝不是”一键生成”的魔法棒，而是需要通过精心设计的工程化手段来引导和约束的生产力工具。</strong></p><p>渐进式提示词和工作流编排代表了当前两个重要的发展方向，它们都在尝试解决同一个核心问题：</p><blockquote><p><strong>如何让 AI 在保持高效率的同时，输出高质量的、可维护的代码？</strong></p></blockquote><hr><h3 id="💼-我的实践建议"><a href="#💼-我的实践建议" class="headerlink" title="💼 我的实践建议"></a>💼 我的实践建议</h3><p>基于这段时间的摸索和实践，我想分享几个具体的建议：</p><h4 id="1-调整心态期望"><a href="#1-调整心态期望" class="headerlink" title="1. 调整心态期望"></a>1. 调整心态期望</h4><ul><li>✅ 接受 AI 生成的是 <strong>POC 级别</strong>的代码，而非完美的生产代码</li><li>✅ 把 AI 当作”<strong>思路启发器</strong>“和”<strong>初稿生成器</strong>“，而非”<strong>全栈替代者</strong>“</li><li>❌ 不要期望一次提示就能得到生产就绪的代码</li></ul><h4 id="2-采用增量迭代"><a href="#2-采用增量迭代" class="headerlink" title="2. 采用增量迭代"></a>2. 采用增量迭代</h4><ul><li>将大任务拆解为小步骤，逐步完善而非一步到位</li><li>每次迭代都明确一个具体目标（如：先跑通，再优化，最后重构）</li><li>保持频繁的人工审查和反馈循环</li></ul><h4 id="3-建立规范体系"><a href="#3-建立规范体系" class="headerlink" title="3. 建立规范体系"></a>3. 建立规范体系</h4><ul><li>制定清晰的编码规范和 AI 使用指南</li><li>建立 AI 生成代码的审查流程（Checklist）</li><li>记录有效的提示词模板，形成团队知识库</li></ul><h4 id="4-保持持续学习"><a href="#4-保持持续学习" class="headerlink" title="4. 保持持续学习"></a>4. 保持持续学习</h4><ul><li>关注最新的 AI 工程化实践和工具</li><li>定期复盘和优化自己的 AI 工作流</li><li>与社区分享经验，学习他人的最佳实践</li></ul><hr><h3 id="🎯-结语"><a href="#🎯-结语" class="headerlink" title="🎯 结语"></a>🎯 结语</h3><p>AI 是强大的生产力工具，但它更像是一个”<strong>超级实习生</strong>“——需要明确的需求、充分的上下文和持续的指导，才能真正发挥价值。</p><p>正如我们不会指望一个实习生第一天就产出完美的代码一样，我们也不应该对 AI 抱有不切实际的期望。相反，我们应该学会如何与 AI <strong>协作</strong>：既利用它的速度和广度，又保持人类的判断力和深度思考能力。</p><p>这或许就是 AI 时代程序员的核心竞争力：<strong>不是被 AI 替代，而是学会驾驭 AI，让它成为我们手中最锋利的武器。</strong></p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2025/12/01/%E6%9C%89%E5%85%B3%E5%9C%A8%E9%A1%B9%E7%9B%AE%E5%AE%9E%E8%B7%B5%E4%B8%ADAI%E7%9A%84%E4%BD%BF%E7%94%A8%E6%96%B9%E6%A1%88/</id>
    <link href="https://maybejustlikethis.github.io/2025/12/01/%E6%9C%89%E5%85%B3%E5%9C%A8%E9%A1%B9%E7%9B%AE%E5%AE%9E%E8%B7%B5%E4%B8%ADAI%E7%9A%84%E4%BD%BF%E7%94%A8%E6%96%B9%E6%A1%88/"/>
    <published>2025-12-01T11:27:38.000Z</published>
    <summary>探讨如何在项目实践中有效使用AI辅助编程，从问题分析到工程化解决方案的完整思考</summary>
    <title>有关在项目实践中AI的使用方案</title>
    <updated>2026-01-13T06:26:59.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="Rain" scheme="https://maybejustlikethis.github.io/categories/Rain/"/>
    <category term="Rain" scheme="https://maybejustlikethis.github.io/tags/Rain/"/>
    <content>
      <![CDATA[<div class="hbe hbe-container" id="hexo-blog-encrypt" data-wpm="抱歉, 这个密码看着不太对, 请再试试." data-whm="抱歉, 这个文章不能被校验, 不过您还是能看看解密后的内容.、">  <script id="hbeData" type="hbeData" data-hmacdigest="5c26752d54ecc255d6f15741683bdf1030ef065ebc573b90509a94c50691d6d1">fcabf9c8b7f9cd7a567a5eda728a396c9ff2fbb669a89066c88b72cdda5412d10411a71059ac86027e6aab0d50f3b5b538d5179c1e000c2e967f9c1ecc4d933b2077b8e92f9f9eacd48019ec05e0503f4f5052846d86fdc74145885dc3a2c8d2b598ed6554c4385315fce2b6b7565a2dafb32bcc0230d143662a2c81d14bdf723beb0100b948106ef9a4ac5ca6b41d4bbfdb98bb20b320413ee9e2debd6f6ca8dee0ab2ab6d631fcd04c56a48258f1ed5e6361848286cbfed25cdef6ecf2ad4660f7458d58f1410a397345e465628693787181c58760f684d41b426c33fb9f380c4c718c19cf8c6e00692d60f0926c6b2fa74812b9d2197db28156e08383c3cba062f9e1fa6fbb2e36d14e1272752fd1b6e92c5eb91ebf4d11dc87442d4a3c1723ef3bef522a681acb53071c9e2248695f597c02cf1e86009d28b3075d8b5c880e2ca65e39b13428aad915bb24a7180b43f4d6abaf043c2cec412df02f65cd54b80ccbfa3228051a12dd432d4a5d6c83ff40a0ab62c68e974192f0b9f46d9210e6fec915469837d362beca84ba9efb66d7fe84935054674e1933e252b1513a7ef9cc53083681ad276eef26b395ed9cb27728df390eb114e87be8afe0d5e9562f80e69298a05261cb097b5fe977c00ac7c0ed46b03fc7fabf795815ace265264a4969cb807a4fb6d7ac55c1022ca5a6a7807e7c8d7312cbcd177146ada7130e31d80df030076db2c7a1d9b769a27cf8f5d76ea0ef0f4694d127e06f15bcc19f4814900f9bdc4f2b2d46638bd6a4675a369cd7709932bbda59af29802eef14cec922487b5b5bcc3a4854a10ebf1b62985d2a606a5914c9fbb44fc1a7c123250771b544c221f1b239fe1d659b37d242ffc85fd6dc5584fe8b341086576cfa5c338b46932e4d82191056773ce7c1ff2d0b944b5860d0713c6c5507a54bcf2279cac09693e19d0fd583beb0e24bfd4b2909dbfc41858a1afcaac0e14f4c1e92bff2be167316000827c758b828f011aa1942ee95d31cb4ce2c592b7f0c6a740163679099b03fcae9b1c7f77a1fb5c6264e5421dfa58680cb04aba1078881f7921052831e306ed2711a639d482309e8e6f287caf8622701e929d26eaf9c6cf1c68daaaabd5a155cf7ad284ecbdc3f8fd5ccf63034987805dd21ef51ee1735dce5df85604b8667f5fe9e84e4209543a23b27a5ac105828039f0ea822e98a1f6981341d26a17b34adcda3adff254bfefdafdc08860b1089e122a1518834c4664eb436c7a4738f29392812514889c38cd3db339bed5c071e73c084d5c8cdd69992dbacf70cdc7b141d3b3da9860d39d325140ab488bf684e5221b724c7a1e5e7a5b78599854f2e6577eb2d8f8e7b957d1ecf8c46942dd0f7f9ebf14e0a6556fbddb8fc99e310d5d0df61951b92ace5f6c2e35e5c2367321a005a11cb76d26019631d96f26fa46761fccee3d9225165f76c470d87c786436aef03ef66a2fbbe5167b09a2bceeb6e96b2d125b482ac1bf32617d4b4dcc3d5d702bee36f474eda176da6299c34e3c44628a05ec4dba9845b259d1294b6b8a6c51e9f337821510f30e97dc3f1ccf89f3b744442f5de2b9187643ee174c4ba92b84762e07cc1bc64fac5063afa4a18c04825943c397c420d39a0758bd7ac3d47fce2dc377fe2688bc331153a2ede9c8f26c3688290c80ed3e4fe48999e4e867828261fe442ff2a426ef747e409564b295d9e62e626cf56cf0afb3ce7f365d6afd3ff7021805a552ebce7555493b945810c8a950c6b308728be0856e75f1473200ca20a0a4cba115dc996d5dbe30744644c199c5fb1de3bc482d0e05e8563876c4f078fc3ab7e4e859ac0407b1e75db95d69f24457fd8484c693cae473b39f9a179825543894f3969e5f7e8f41c47db0f3be5a28146d70b0db132aa453255dcf8809430ce21f9b22c0174f0f3f8cb29cf6dbd99c255f8a3b707140b85a1fc47910e11393a996b96846f978d8de3b06eee88edae0e8d89c46d330497f1e38ea14adb249af46938a56ddea42b8bd18e61401cb1b6d5c4de83065b37c488956e71b3586ef9c6cd7d3fcdf1ad3531faaaba471f18c4fd544f37657f779f6f6dfbdecb198deeaafadacff8e246aa82554508911113ba313f420b5af3abde1e99114b45f5380ef5a57e32cf3e02d7d84d9a37712ebdba2d7c1660a0cd85a64c96ac5fff64ce454913b11d624e1fa8f776b2e2191d4219622723999ddd83bafd2edc4027284af429a2a7fe33fac913ee2216aae00e5eeab90becd95ddfa17abeab97273e65f21f557f69dbeb6676cd0b90f0c5966d513aaa292a98977ce957c55027ed83d902f161fc2fd68be9fa8fe5926a5c07029d101218adde1bc47ee6298a28f8fef5c89ed7dce2ad7a4074df7591a9f27c8d43012f5280f4c8d6297a3536b047d847540d319baac1501f5f932fc78080ca3d2cc969bfa2c5e5e5612169462d11aec2612de7f30a502676fd6a928c9d436b2f8dc6b2ce10027acfed95e21b1c87863e0f08bf726e321218e2cf4f9663f17819623eb354bdd55b9f2835930d2b941f98d6aaf41dcc2ca66c77c0bdd82531603b0695835b1c81afc0e7abcf7e885d04fe11fde45a40329624e1b10eb4ae104fe836f1a087ec6481768d4667435167f2d0fb4f788592a0c5c78a47736843150c79f5cf27a80c5101b1ec2308b30b14bc2447c309fb667ef69b9f74830de0b2b079080e630ba9c42334c95013424895834e8d3b946b390bcff2023b9716b08bd11233827848d899f51a392ff39026382a6e4ed68d13f58917ce115b48af3ad86d2f8c8e64141c37e9fe2430aedf14498da5ab25777594a59dd17051313d7f30dba2c64d526e328538f2e20c7b997c3fd98da9a17aac9aa15f72b6ead459c924b6dc0394f84392053651407fe10769078395c98632632b12aa65e1317d277afcad7c0bdc219a84956d3042e23943d5e65af6c8f707aac1342533b4953d0d7408e30fcae1ae128a0d603545aee9958a581a22b7d389fa30d96a0d50b883713aa7e9fcd15a78b92a762f8e6c3b2e38a5ba274fdf5dbcd6023271efa81cd683ee4b270bf1a16a6c12140410f764fe4f46e0e59e8a577662f762689cba8798c0209d8d1937717c5bf41e10f54b27712806c774c30c9a125d353ee9119b3f710e8c4da0ae7d89cb037c880afe0ca5093364aea466732679a7553311e4bcc4c396dae9442779e88d5613690c950a2c15550fc69d098eafe4ce98ad23330393ba4a4127c6f847cdccb11cd837e97f9df89e3d93316071980c5560430b70e2c0545adf3a66ac241087981faf3e2f09c1a08f2a55cc82ca6b2e81b4dea809fad690eabd5b9e3bd442ed0f0724d946002809b8f92d2aca9fbf9f99dfcefccaa48ac21864097fb05452b37012b3bd6aed1e426cb82e2baabb9387cc69f3c6796b0acabcacb42b041e41568cd925e7d662f89b4131b61890ea1516ac8a1b353e33c0c6a88a08c93866933c4ac45cf14be8bf2a16c6473256c3a5a2fc8f05a761abff761eb88b54f39cc607a12a994e4ede011bc2f0e2214b964a9f10a873f1088296318e198e1ed6d897396ac3a5aa4eb70c4438fe7238fb479f41ade7f39ef38861717c8c</script>  <div class="hbe hbe-content">    <div class="hbe hbe-input hbe-input-surge">      <input class="hbe hbe-input-field hbe-input-field-surge" type="password" id="hbePass">      <label class="hbe hbe-input-label hbe-input-label-surge" for="hbePass">        <span class="hbe hbe-input-label-content hbe-input-label-content-surge" data-content="您好, 这里需要密码.">您好, 这里需要密码.</span>      </label>      <svg class="hbe hbe-graphic hbe-graphic-surge" width="300%" height="100%" viewBox="0 0 1200 60" preserveAspectRatio="none">        <path d="M1200,9c0,0-305.005,0-401.001,0C733,9,675.327,4.969,598,4.969C514.994,4.969,449.336,9,400.333,9C299.666,9,0,9,0,9v43c0,0,299.666,0,400.333,0c49.002,0,114.66,3.484,197.667,3.484c77.327,0,135-3.484,200.999-3.484C894.995,52,1200,52,1200,52V9z"></path>      </svg>    </div>  </div></div><script data-pjax src="/lib/hbe.js"></script><link href="/css/hbe.style.css" rel="stylesheet" type="text/css">]]>
    </content>
    <id>https://maybejustlikethis.github.io/2025/11/23/%E4%BD%93%E8%B4%A8%E6%8C%BD%E6%95%91%E8%AE%A1%E5%88%92/</id>
    <link href="https://maybejustlikethis.github.io/2025/11/23/%E4%BD%93%E8%B4%A8%E6%8C%BD%E6%95%91%E8%AE%A1%E5%88%92/"/>
    <published>2025-11-23T12:16:38.000Z</published>
    <summary>体质太弱了！给我运动起来</summary>
    <title>体质挽救计划</title>
    <updated>2026-10-20T04:12:53.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/categories/%E6%9D%82%E8%B0%88/"/>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/tags/%E6%9D%82%E8%B0%88/"/>
    <content>
      <![CDATA[<h1 id="秋招后闲谈"><a href="#秋招后闲谈" class="headerlink" title="秋招后闲谈"></a>秋招后闲谈</h1><blockquote><p>盛年不重来，一日难再晨。及时当勉励，岁月不待人。——陶渊明  </p></blockquote><p>2025年11月10号，也是感觉算是人生一个小里程碑了吧，毕竟算是人生第一份工作了，对于我这样的学历背景来说，也是没什么好不满意的了。</p><p>但是心中百味杂陈，今天正好是我告别Rain离开北京的一天，北京的风带上了伤感的意味，在意识到 我签了这份协议，明年就成为一名在社会层面上的“人”了，不是学生，不是会被社会保护的身份，就像雏鹰第一次被逼下悬崖——我可能算是拥有了在社会上翱翔的资格。我庆幸于自己早日的觉醒，早日的为了自己的职业生涯而努力，也庆幸在努力的过程中遇到了我的初恋，这样一想似乎已经是一个不错的结果了，我是说，你知道的朋友，毕竟生活中没那么多英雄主义。</p><p>也许我曾经也幻想过自己可能会成为一个名人，一个对社会做出杰出贡献的人，科学家，运动员，或者是一名杰出的作曲家，但是很显然 我并没有做到这些，我选择入职美团也是因为我赞同美团的理念，“让大家吃的更好，穿的更好”。这样给我一种 我也为了社会的大众做出了一些力所能及的贡献？让大家及时的吃饱饭？哈哈，民以食为天嘛。</p><p>我现在在绿皮火车上。去北京时为了更快的见到Rain，坐了高铁，在回去时，追求速度也无甚意义。不得不说，火车和高铁确实是有很多不同的，记得去时的高铁上，坐在我旁边的女士，正是要去北京找比较好的医院去做人流（女士在我旁边打的电话，不是故意听的），正忧愁于术后的痛苦，但是她的丈夫似乎并未陪同。而在火车上，情况就比较复杂了：铺天盖地的行李，大包小包，充满着气味的食物，还见到了许多背着比自己大一倍还要多行李的中老年女士，蹒跚前行，她们会从不知道哪个包里掏出一个水果小口的吃着，她们也不理解为什么16:40开的火车16:00就开始检票了，担心为什么这么长时间火车都不开，于是找我反复确认了火车班次……</p><p>大家生活是不同的，互联网害了很多人，人类社会还在遵循着最基本的自然守则，世界就是一个草台班子。其实我意识到了我想要的生活是什么样子的，但是我被裹挟了，的的确确被裹挟了，但是又无法改变，改变，改变会带来春天的浪潮，谁又不想看到春天来呢……</p><p>附一张雍和宫口拍的银杏树：<br><img src="/2025/11/11/%E5%BC%80%E5%A5%96%E5%90%8E%E6%9C%89%E6%84%9F/d6a8a9ef33f0528d0686cecb3a312c5f.webp"></p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2025/11/11/%E5%BC%80%E5%A5%96%E5%90%8E%E6%9C%89%E6%84%9F/</id>
    <link href="https://maybejustlikethis.github.io/2025/11/11/%E5%BC%80%E5%A5%96%E5%90%8E%E6%9C%89%E6%84%9F/"/>
    <published>2025-11-11T11:24:45.000Z</published>
    <summary>开奖后有感</summary>
    <title>开奖后有感</title>
    <updated>2026-10-19T15:31:12.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/categories/%E6%9D%82%E8%B0%88/"/>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/tags/%E6%9D%82%E8%B0%88/"/>
    <content>
      <![CDATA[<h1 id="6月20日有感"><a href="#6月20日有感" class="headerlink" title="6月20日有感"></a>6月20日有感</h1><blockquote><p>”存在先于本质。“ ————让-保罗·萨特</p></blockquote><p>好长时间没有写博客了，最近都在忙于学校的课设考试，忙里偷闲，包括在工作中学习，在学习中工作，除了身体很累都还是不错的，感情方面也在向好的方向发展，但是在不断的忙碌中，不知是激素调节还是什么原因,终归 是对生活的意义有了一定的质疑,突然我发现 : “我不知道生活的意义是什么.”</p><p>我认为这是多年的应试教育带来的问题,在学校的环境下,多年的”老师教,学生学”的模式导致了如果你在人生路上没有一个清晰的目标的话,你会陷入迷茫:”你想活出怎么样的人生?”.是学习网络上的四处旅游,亲近大自然?还是说想要发大财,去学习理财,去创业?亦或者只想找一份稳定的工作,安逸的度过平凡的一生?</p><p>你想成为什么样的人按下不谈,我也难以理解，但是我知道我想要什么，我想要的东西有很多:我喜欢音乐,我想要玩音乐,成为一名混音师;我喜欢看小说,我喜欢阅读,我想要成为一名书推人;我想要玩摄影,我想要成为一名摄影师;我还喜欢骑行,我也想试着成为一名骑行者;最后我还是一名程序员,我喜欢Coding,喜欢用代码为大家带来更好的生活.最近读到了一本书:原子习惯(Atomic Habit),里面有一句话,意思大抵是 “你的习惯构成了你的身份,构成了你”,其实我更想说:”我首先存在,然后我的喜好,我的厌恶,我的行为才构成了我”。</p><p>所以有时候思考这么多有什么用呢，其实生活终归还是柴米油盐，但是“人是会思考的芦苇”，我觉得这句话说的非常好：人是脆弱的，是会左右摇摆的，但特殊之处就在于人会思考，如果人放弃了思考，那可就成为了真正的芦苇了。</p><p>接下来应该也会继续坚持写作的习惯吧。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2025/07/03/6%E6%9C%8820%E6%97%A5%E6%9C%89%E6%84%9F/</id>
    <link href="https://maybejustlikethis.github.io/2025/07/03/6%E6%9C%8820%E6%97%A5%E6%9C%89%E6%84%9F/"/>
    <published>2025-07-03T12:55:38.000Z</published>
    <summary>6月20日临时有感</summary>
    <title>6月20日有感</title>
    <updated>2025-11-15T10:37:17.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="AI" scheme="https://maybejustlikethis.github.io/categories/AI/"/>
    <category term="AI" scheme="https://maybejustlikethis.github.io/tags/AI/"/>
    <content>
      <![CDATA[<p>最近花了大概两个多小时把吴恩达在 DeepLearning.AI 上和 Anthropic 合作出的那门《Agent Skills with Anthropic》刷完了。课程本身不复杂，10节课，每节都不长，但信息密度挺高的。本来打算一篇笔记写完，结果发现内容实在太多，还是拆成上下两篇比较合适。</p><p>这一篇先聊最核心的问题：<strong>Skills 是什么，它解决了什么问题，以及它和 Tools、MCP、Subagents 这些概念到底有什么区别。</strong></p><h2 id="Skills-的本质：一个文件夹而已？"><a href="#Skills-的本质：一个文件夹而已？" class="headerlink" title="Skills 的本质：一个文件夹而已？"></a>Skills 的本质：一个文件夹而已？</h2><p>说起来有点不可思议，Skills 的核心载体就是一个<strong>文件夹</strong>。</p><p>对，就是你在电脑上每天创建的那种文件夹。里面必须有一个 <code>SKILL.md</code> 文件，包含 YAML 头部的名称和描述，以及具体的指令内容。然后你可以选择性加一些子目录——<code>references/</code> 放参考文档，<code>scripts/</code> 放执行脚本，<code>assets/</code> 放资源文件。</p><p>就是这么简单。</p><figure class="highlight plaintext"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><span class="line">my-skill/</span><br><span class="line">├── SKILL.md          # 核心指令（名称 + 描述 + 详细指令）</span><br><span class="line">├── references/       # 参考文档</span><br><span class="line">├── scripts/          # 执行脚本</span><br><span class="line">└── assets/           # 模板、图片等资源</span><br></pre></td></tr></table></figure><p>但我越往下看越觉得，这个”简单”的设计其实是经过深思熟虑的。Skills 要解决的不是”如何让 AI 更聪明”，而是另一个完全不同的问题：<strong>如何让 AI 稳定地、可重复地执行一个专业领域的工作流。</strong></p><p>很多时候我们和 AI 对话的问题是：你上个月教过它的东西，这个月还得重新教一遍。你上次精心调试好的提示词，换个会话窗口就没了。每次都要重新描述需求，重新打包参考材料，重新解释”这个事情的背景是这样的”。这些重复劳动消耗的不只是时间，还有一种很难描述的认知负担——你要一直保持”我在教一个聪明但不太了解情况的助手”的状态。</p><p>Skills 的答案很直接：把专业知识和操作流程写成文件，放进文件夹，需要的时候按需加载。</p><h2 id="核心机制：渐进式披露"><a href="#核心机制：渐进式披露" class="headerlink" title="核心机制：渐进式披露"></a>核心机制：渐进式披露</h2><p>如果仅仅是把指令写成文件，其实没什么新鲜的。Skills 真正巧妙的地方在于它的<strong>三层加载策略</strong>，官方叫 Progressive Disclosure。</p><p>这个设计解决了一个很实际的痛点：上下文窗口是有限的。</p><p>你不可能把几十个 Skill 的完整内容全部塞进上下文里，那样的话 AI 还没开始干活就已经被各种指令淹没了，而且每一轮对话都要为这些”可能用不到”的指令支付 token 成本。</p><p>渐进式披露的做法是这样：</p><table><thead><tr><th>层级</th><th>加载内容</th><th>什么时候加载</th><th>Token 成本</th></tr></thead><tbody><tr><td>第一层</td><td><code>name</code> + <code>description</code>（YAML 头部元数据）</td><td>始终在上下文中</td><td>约 100 tokens 每个</td></tr><tr><td>第二层</td><td><code>SKILL.md</code> 的完整指令正文</td><td>当 Agent 判断该 Skill 与当前任务匹配时</td><td>一般不超过 5000 tokens</td></tr><tr><td>第三层</td><td><code>references/</code> <code>scripts/</code> <code>assets/</code> 中的文件</td><td>当具体执行需要参考资料时</td><td>按需加载</td></tr></tbody></table><p>这个设计的精妙之处在于：<strong>你理论上可以拥有无限多个 Skill，但上下文成本是可控的。</strong> Agent 先看”菜单”（名称和描述），点菜之后才上菜（完整指令），最后需要参考配料时才查文档（资源文件）。</p><p>某种意义上，这和人类的认知方式挺像的。你不会把所有知识时刻放在脑子里，大部分东西都是以”索引”的形式存在——你知道它能解决什么问题，应该在什么场景下使用，但直到真正需要时，才会把详细的知识调出来。</p><h2 id="Skills-不是什么万能胶"><a href="#Skills-不是什么万能胶" class="headerlink" title="Skills 不是什么万能胶"></a>Skills 不是什么万能胶</h2><p>课程里有一节专门讲 Skills 和其他几个概念的区别，我觉得这是整个课程最值得认真看的部分。因为这几个概念确实容易搞混，但它们各自解决的问题其实不同。</p><p><strong>Tools（工具）</strong></p><p>工具是原子操作。读取文件、执行代码、发起网络请求——这些都是”手”和”脚”，让 Agent 能够与环境交互。工具始终挂在 Agent 的上下文里，永远可用。</p><p>Skills 不是工具。Skills 更像是<strong>使用工具的方法论</strong>。”如何用锤子和锯子做一个书架”，而不是锤子和锯子本身。</p><p><strong>MCP（Model Context Protocol）</strong></p><p>MCP 解决的是<strong>连接外部系统</strong>的问题。Google Drive、GitHub、数据库、API——MCP 是一个标准协议，让 Agent 能访问外部数据和服务。可以把它理解成万能数据插座。</p><p>Skills 和 MCP 的关系是互补的：MCP 负责”拿到数据”，Skills 负责”知道怎么处理数据”。两者组合起来才是完整的。</p><p><strong>Subagents（子代理）</strong></p><p>Subagents 是<strong>独立的执行单元</strong>，拥有自己独立的上下文窗口和工具权限。你可以给不同的子代理配置不同的工具、不同的权限、不同的 Skills。</p><p>区别在于：Skills 是”培训手册”，Subagents 是”专职员工”。Skill 加载到主 Agent 的上下文里使用，Subagent 则是把任务派发出去，在隔离的环境里执行。</p><p>这两者也可以组合：一个 code-reviewer 子代理可以加载 python-security 这个 Skill——独立的执行环境加上可移植的专业知识。</p><p><strong>简单总结一下这几个概念的分工：</strong></p><ul><li><strong>Tools</strong>：给 Agent 手和脚，让它能做事</li><li><strong>MCP</strong>：给 Agent 数据来源，让它能连接外部世界</li><li><strong>Skills</strong>：给 Agent 经验和方法，让它知道怎么做事</li><li><strong>Subagents</strong>：给 Agent 独立分身，让不同任务互不干扰</li></ul><p>它们不是互相替代的关系，而是各管一摊，组合起来才是完整的 Agent 能力体系。</p><h2 id="一个具体的例子"><a href="#一个具体的例子" class="headerlink" title="一个具体的例子"></a>一个具体的例子</h2><p>课程里用了一个市场营销分析的案例来演示 Skills 的价值。</p><p>假设你要做一个营销活动分析报告，流程大概是：从 BigQuery 拉数据 → 做数据分析和洞察 → 按品牌调性写成报告 → 生成 PPT。</p><p>没有 Skills 的情况下，你得一步步告诉 Agent 怎么做每一步，解释品牌调性是什么，报告格式长什么样，PPT 模板在哪。</p><p>有了 Skills 之后，这个过程就变成：</p><ol><li><strong>BigQuery Skill</strong> 负责数据查询逻辑（SQL 模板、表结构说明）</li><li><strong>Marketing Analysis Skill</strong> 负责分析框架（指标解释、分析维度、benchmark 参考）</li><li><strong>Brand Skill</strong> 负责品牌调性（文案风格、视觉规范、禁忌事项）</li><li><strong>PowerPoint Skill</strong> 负责输出格式（模板文件、排版规则、图表样式）</li></ol><p>这几个 Skill 可以串联成一个端到端流程，而且每个人都可以复用别人写好的 Skill。更重要的是，<strong>同一个 Skill 可以在 Claude Code、Claude.ai、API、Agent SDK 甚至 Cursor 和 Trae 里使用</strong>——因为 Skills 已经是一个开放标准，不是某个产品的专属功能。</p><h2 id="我的一点感受"><a href="#我的一点感受" class="headerlink" title="我的一点感受"></a>我的一点感受</h2><p>我觉得 Skills 最值得关注的地方，不在于技术有多复杂——说实话，文件夹加 Markdown，真的不复杂。它值得关注的地方在于它指向了一个方向：<strong>AI 应用的工业化正在从”写好提示词”走向”构建可复用的知识资产”。</strong></p><p>之前我们用 AI，更多是手工作坊模式——每次都是一个 prompt 接一个 prompt，靠个人手艺，难以规模化。Skills 相当于把那些经过验证的、可以重复使用的专业知识，用文件的形式资产化了。你不会丢失它，可以迭代它，可以分享它，可以用在任何兼容的 Agent 上。</p><p>而且它能显著提高一致性。课程中演示了 Brand Skill 如何确保输出风格统一、品牌调性不跑偏，这背后其实是让 AI 的行为更像”可预期的助手”，而不是每次随机发挥。</p><p>某种意义上，Skills 的价值会随着时间累加。你写的 Skill 越多，能复用的积累越深，后面做事情的效率提升越明显。这和传统软件开发里”造轮子 vs 调库”有异曲同工的地方——一开始写 Skill 可能要花些心思，但一旦形成库，后续的工作就变成了搭积木。</p><p>下篇会聊更实操的部分：怎么创建自定义 Skill，以及在不同环境（API、Claude Code、Agent SDK）里具体怎么用。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2025/07/03/%E5%90%B4%E6%81%A9%E8%BE%BE%E7%9A%84skill%E8%AF%BE%E7%A8%8B%EF%BC%88%E4%B8%80%EF%BC%89/</id>
    <link href="https://maybejustlikethis.github.io/2025/07/03/%E5%90%B4%E6%81%A9%E8%BE%BE%E7%9A%84skill%E8%AF%BE%E7%A8%8B%EF%BC%88%E4%B8%80%EF%BC%89/"/>
    <published>2025-07-03T12:55:38.000Z</published>
    <summary>吴恩达Agent Skill学习笔记（一）——Skills的本质、渐进式披露机制，以及它和Tools、MCP、Subagents的区别</summary>
    <title>吴恩达的skill课程（一）：Agent Skills到底是什么</title>
    <updated>2026-05-08T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/categories/%E6%9D%82%E8%B0%88/"/>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/tags/%E6%9D%82%E8%B0%88/"/>
    <category term="实习" scheme="https://maybejustlikethis.github.io/tags/%E5%AE%9E%E4%B9%A0/"/>
    <content>
      <![CDATA[<h2 id="快手实习总结"><a href="#快手实习总结" class="headerlink" title="快手实习总结"></a>快手实习总结</h2><h3 id="实习氛围"><a href="#实习氛围" class="headerlink" title="实习氛围"></a>实习氛围</h3><p>快手作为我实习的第一个大厂，周围的同事还是比较友好的，有不会的去问大家也会耐心地给我解答，平时还是有比较充裕的学习时间，大家加班也不是太严重，我觉得还是相当不错的，基本晚上8点就能走，平时也有很多的大的小的活动可以参加，个人感觉还是很不错的。</p><h3 id="技术成长"><a href="#技术成长" class="headerlink" title="技术成长"></a>技术成长</h3><p>主要的学习成长在于技术视野的成长和学习node和babel，还有就是开发能力的提升和用cursor来为开发提速，平时看一些内部文档，虽然有很多的专业名词，但是还是能学到不少东西的。</p><h3 id="其他的话"><a href="#其他的话" class="headerlink" title="其他的话"></a>其他的话</h3><p>很多一部分是学到了一些大厂开发的大致流程，并且有一定程度上的了解，但是了解到不同的厂之间可能有一些微妙的区别，这个之后再辨析吧，很幸运的也是面试到了美团的转正实习，希望下一段美团的实习能够获得更大的提升吧。</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2025/04/28/%E5%BF%AB%E6%89%8B%E5%AE%9E%E4%B9%A0%E6%80%BB%E7%BB%93/</id>
    <link href="https://maybejustlikethis.github.io/2025/04/28/%E5%BF%AB%E6%89%8B%E5%AE%9E%E4%B9%A0%E6%80%BB%E7%BB%93/"/>
    <published>2025-04-28T06:09:28.000Z</published>
    <summary>快手实习经历的感受和收获</summary>
    <title>快手实习总结</title>
    <updated>2025-11-15T10:37:17.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/categories/%E6%9D%82%E8%B0%88/"/>
    <category term="杂谈" scheme="https://maybejustlikethis.github.io/tags/%E6%9D%82%E8%B0%88/"/>
    <content>
      <![CDATA[<blockquote><p>”世界上只有一种真正的英雄主义，那就是在认清生活真相之后依然热爱生活。“ ————罗曼罗兰《米开朗基罗传》</p></blockquote><p>时光匆匆，转瞬之间已是20的年纪，对于2024年，这一年有许许多多的难以忘怀的事情，大二-大三的变化，没有大一的青涩，也没有大三大四的需要为未来考虑，是人生少有的为自己而活的短暂时光，在年关将至的今天，想着是该写点什么来纪念自己的20岁，于是有了这篇内容。</p><h3 id="春天"><a href="#春天" class="headerlink" title="春天"></a>春天</h3><p>写点什么总要有一些依据吧，但是本人记性又不是太好，幸好iPhone的相册记录了时间，<br>在看到第一张照相时就有种时空回溯的感觉，记忆涌上心头，那是一张五人合照，是在24年的元旦当天，这一天非常有趣，在当天帮一个朋友表白之后，我们五条单身狗（doge）走在回学校路上感慨万千，临时起意去通宵玩桌游，现在想来是多么有趣的时光！</p><p>然后还有当时在数港学习的工位照片，现在还记得大家都离开之后我依然在工位上刷着lc的链表题，外面天黑，安静学习的感觉是那么美好。</p><p>之后就放寒假过年，与亲朋好友过年，24年的过年伴随着一场又一场的大雪，瑞雪兆丰年吧，24年我觉得是很有意义的一年。</p><p>开学还给书院招了下一届的生，与老师沟通调解一些矛盾，这会已经有些风声书院要被取代，只能说这个时候大家斗争的精神还是很充足的。</p><h3 id="夏天"><a href="#夏天" class="headerlink" title="夏天"></a>夏天</h3><p>孟夏，这段时光在保持学习的同时和同学们到处吃吃喝喝，还写了个周围好吃的的总结，就是嘴比较馋，到处约饭，还和朋友约着一起去了人生第一次漫展，现在想起来我还是很社恐（感觉大家都很光鲜亮丽）</p><p>对了还和好朋友们一起去了五台山看日出，印象中这应该是我第一次看日出吧，那天很冷，条件也很恶劣，但是现在想起来的只有当天大家一起经历的美好，</p><p>仲夏，日子照样在一天天过去，每天都在按部就班的学习课程，学习前端，然后就是吃吃吃吃吃吃吃 之后就是学习，最终面试到了北京的一家公司做实习生，个人感觉虽然没有学到多么高深的知识，但是学会了很多东西：协作流程，自己租房，自己一个人生活，什么事情都是自己干，这些珍贵的社会经验；</p><p>除了实习之外，还和在北京一起实习的好朋友们 一起夜骑40公里去看升旗，去看天安门，在晚上 金碧辉煌的天安门城楼让我印象深刻；但是我这个人有点奇怪的爱好：在很多关键时刻我不喜欢去观看事件本身，我更喜欢看别人在这一刻的反应；我通过其他人震撼的表情，我再去看夜间的天安门城楼，心中不禁为天安门城楼添加上了一丝神性，多少革命前辈的英魂环绕其上，熠熠生辉。</p><h3 id="秋天"><a href="#秋天" class="headerlink" title="秋天"></a>秋天</h3><p>到了9月，记忆中就是在学校远程实习了一个月，然后买了今年新加的电子产品：apple watch S9（刚买S9，S10就出了呜呜），虽然感觉没什么用，但是就是很喜欢美丽废物，感觉更像是一个装饰品。</p><p>10月份主要处理了书院的事务，书院有了大的变动，也要对下一届进行一些事务上的交代，之后还组织大家进行了团建；</p><h3 id="冬天"><a href="#冬天" class="headerlink" title="冬天"></a>冬天</h3><p>11月 12月 基本上就是按部就班的学习，生活，偶尔和舍友出去玩 ，其中和舍友说走就走去了天津，我只能说虽然有些许遗憾，但是果然旅游这种事情就不会无趣，天津真的是很美的城市！</p><p>1月份就是期末考试紧张的复习，和准备面试相关的东西，之后经过面试，也是成功去快手实习了，为我的2024年画上一个完美的句号。看似我的2024很平凡，但其实很多美好的瞬间都藏在日常生活中不经意的小细节中，只有全身心投入生活，才能体会到其中真谛；</p><p>2025年希望我能身体健康，拿到属于自己心仪的offer！</p>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2025/01/27/2024%E5%B9%B4%E5%BA%A6%E6%80%BB%E7%BB%93/</id>
    <link href="https://maybejustlikethis.github.io/2025/01/27/2024%E5%B9%B4%E5%BA%A6%E6%80%BB%E7%BB%93/"/>
    <published>2025-01-27T02:31:28.000Z</published>
    <summary>24年度总结</summary>
    <title>2024年度总结</title>
    <updated>2025-11-15T10:37:17.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>MaybeJustLikeThis</name>
    </author>
    <category term="算法" scheme="https://maybejustlikethis.github.io/categories/%E7%AE%97%E6%B3%95/"/>
    <category term="笔记" scheme="https://maybejustlikethis.github.io/tags/%E7%AC%94%E8%AE%B0/"/>
    <category term="算法" scheme="https://maybejustlikethis.github.io/tags/%E7%AE%97%E6%B3%95/"/>
    <content>
      <![CDATA[<h2 id="二叉树"><a href="#二叉树" class="headerlink" title="二叉树"></a>二叉树</h2><p>涉及到二叉树的<strong>构造</strong>，无论普通二叉树还是二叉搜索树一定<strong>前序</strong>，都是先构造中节点。</p><p>求普通二叉树的<strong>属性</strong>，一般是<strong>后序</strong>，一般要通过递归函数的返回值做计算。</p><p>求<strong>二叉搜索树</strong>的属性，一定是<strong>中序</strong>了，要不白瞎了有序性了。</p><p>合并二叉树：和一个二叉树逻辑差不多，递归函数传俩值，分别判断两节点；<br>二叉搜索树：重点是使用<strong>中序遍历</strong>存一个有序数组，之后数组操作；也可用全搜索的形式，来在递归过程中进行更新；</p><figure class="highlight js"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br></pre></td><td class="code"><pre><span class="line"><span class="keyword">var</span> getMinimumDifference = <span class="keyword">function</span> (<span class="params">root</span>) &#123;</span><br><span class="line">    <span class="keyword">let</span> res = <span class="title class_">Infinity</span></span><br><span class="line">    <span class="keyword">let</span> preNode = <span class="literal">null</span></span><br><span class="line">    <span class="comment">// 中序遍历</span></span><br><span class="line">    <span class="keyword">const</span> <span class="title function_">inorder</span> = (<span class="params">node</span>) =&gt; &#123;</span><br><span class="line">        <span class="keyword">if</span> (!node) <span class="keyword">return</span></span><br><span class="line">        <span class="title function_">inorder</span>(node.<span class="property">left</span>)</span><br><span class="line">        <span class="comment">// 更新res</span></span><br><span class="line">        <span class="keyword">if</span> (preNode) &#123;</span><br><span class="line">            res = <span class="title class_">Math</span>.<span class="title function_">min</span>(res, node.<span class="property">val</span> - preNode.<span class="property">val</span>)</span><br><span class="line">        &#125;</span><br><span class="line">        <span class="comment">// 记录前一个节点         </span></span><br><span class="line">        preNode = node</span><br><span class="line">        <span class="title function_">inorder</span>(node.<span class="property">right</span>)</span><br><span class="line">    &#125;</span><br><span class="line">    <span class="title function_">inorder</span>(root)</span><br><span class="line">    <span class="keyword">return</span> res</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>]]>
    </content>
    <id>https://maybejustlikethis.github.io/2024/11/15/%E7%AE%97%E6%B3%95%E7%AC%94%E8%AE%B0/</id>
    <link href="https://maybejustlikethis.github.io/2024/11/15/%E7%AE%97%E6%B3%95%E7%AC%94%E8%AE%B0/"/>
    <published>2024-11-15T12:57:22.000Z</published>
    <summary>算法部分感悟</summary>
    <title>算法笔记</title>
    <updated>2026-01-13T06:26:59.000Z</updated>
  </entry>
</feed>